延遲#
關鍵詞
延遲 是單個像素從相機(或其他來源)輸入通過產生的 FPGA 管線傳輸到輸出所需的時間,例如 DmaToPC。該延遲發生在圖像擷取卡上,而不是在 VisualApplets 編輯器中。 頻寬 是指每秒可以流經連結的像素數量。
設計可以同時具備高頻寬與低延遲:許多像素以 Parallelism 穿過 FPGA 管線,但影格的第一個像素在交給 DMA 之前仍然需要一些時間。
延遲與頻寬#
Bandwidth 與 latency 描述了同一管線的不同 Property:
| 頻寬 | 延遲 | |
|---|---|---|
| 問題 | 每秒流動多少資料? | 一個像素要等待多久才能被處理? |
| 取決於 | Parallelism 與基礎設計時脈 | 運算子類型與演算法 |
| 公式(連結) | Bandwidth = parallelism × Base Design Clock | 每個運算子各有定義;請參見下文 |
管線可以同時傳輸與處理影像資料。例如,當第 1000 個像素已經到達輸出端時,第 5000 個像素可能仍在攝影機輸入端。整體的資料速率(頻寬)保持很高,因為多個像素在設計中以 Parallelism 運行。延遲僅描述個別像素的延遲。
設計準則
在從 VisualApplets 設計產生的 FPGA 管線中,延遲保持接近理論最小值。多數 operator 不會儲存完整的影像。它們一取得資訊就會立即轉發結果。
延遲定義#
延遲 是像素在設計中的延遲 — 從像素進入處理鏈到離開的時間(例如,直到它到達) DmaToPC)。
重要要點:
- 延遲由每個 operator 個別定義,且主要取決於其演算法實作。
- 新增模組不會降低產能。產生的 FPGA 管線中的所有階段均以平行方式執行:當一個模組處理某個像素時,其他模組會同時處理其他像素。管線填滿後,較長的鏈結依然可以在每個時脈週期接收新的像素(或像素封包)。
- 新增 operator 可能會增加延遲。每個 operator 可能會增加單一像素路上的延遲,而這些延遲會在整條鏈結上累積。來自 O-type operator 的幾個時脈週期延遲,與緩衝區的行或張延遲相比通常很小。
- 延遲與阻塞或緩衝區 Fill 程度不同。如果下游處理緩慢,緩衝區可能會填滿,且延遲會進一步增加。本主題說明 operator 本身內建的最小延遲。
範例設計#
本主題全程使用以下設計。它顯示了一個包含一個緩衝區和兩個處理步驟的簡單擷取路徑:
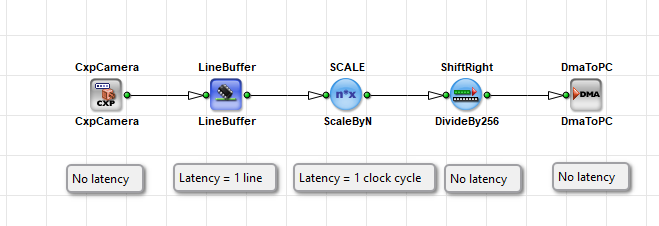
上述設計中的延遲標註適用於這個特定範例:
| Operator | 此範例中的延遲 |
|---|---|
CxpCamera | 此範例中無額外的演算法延遲 |
LineBuffer | 1 行 |
ScaleByN | 1 個時脈週期 |
ShiftRight | 無額外延遲 |
DmaToPC | 此範例中無額外的演算法延遲 |
此路徑上像素的總延遲主要取決於 一行延遲 的成員 LineBuffer的一行延遲決定,再加上其他 operator 的微小處理延遲。「No additional algorithmic latency」代表 CxpCamera 和 DmaToPC 意味著這些 operator 在此範例中不會增加該類型的額外延遲。這並不代表像素會立即顯示在 PC 上。攝影機介面時序、PCIe 傳輸、主機緩衝以及顯示皆不在本表格範圍內。
範例設計中的像素流#
在此範例設計中,像素會透過相機介面從相機傳輸至 LineBuffer。Vignetting Correction LineBuffer 在將資料轉發至輸出之前,會收集完整的一行。
在將完整的一行儲存至 LineBuffer, 緩衝區會輸出該行中的像素。在 同一時間,相機已經將 下一行. 這是所產生 FPGA 硬體的管線化運作方式:擷取、緩衝、處理及 DMA 作業可重疊進行。VisualApplets 描述了該管線;它本身並不處理攝影機的影像串流。
計算延遲#
延遲取決於 operator。整個設計沒有單一數值。您可以將單一像素路徑上的延遲加總(或依時間追蹤)。
基於行的延遲(緩衝區運算子)#
緩衝區 operator,例如 ImageBuffer 和 LineBuffer 至少需要 完整的一行 才能輸出該行的第一個像素。針對 LineBuffer 在上方的範例中:
延遲 = 1 行
以時間測量,一行的延遲為:
行延遲 = (每行像素數) / (鏈結的像素速率)
像素速率取決於 Parallelism 與 Base Design Clock。較寬的行或較慢的鏈結會增加第一個像素離開緩衝區的時間。
時脈週期延遲(處理運算子)#
許多處理 operator 會將像素延遲固定的時脈週期數。在管線填滿後,它們仍然可以在每個時脈週期接受並輸出一個像素(或一組平行的像素封包)。單一像素的延遲因此僅為這些內部暫存器階段。
在此範例設計中, ScaleByN 新增了:
延遲 = 1 個時脈週期
以時間測量,一個時脈週期的延遲為:
週期延遲 = 1 / Base Design Clock 頻率
例如,在 Base Design Clock 為 312.5 MHz 時,一個時脈週期為 3.2 ns。
Operator,例如 ShiftRight 在此範例中,會增加 無實質意義的延遲 實務上。一旦輸入值可用,它們就會立即轉發結果。
運算子類型與延遲#
VisualApplets 將運算子分為不同的類型。此類型可協助您估算延遲:
| Type | 圖示形狀 | 典型延遲行為 |
|---|---|---|
| O-type | 圓形 | 非常小的固定延遲——通常為固定數量的時鐘週期。例如:約3.2 ns的延遲(以 312.5 MHz 基本設計時鐘計算為一個週期)。 |
| M型 | 正方形 | 可變延遲。可對行或幀進行緩衝、變更影像尺寸,或阻斷輸入。請參閱操作手冊以確認確切的延遲時間。 |
| P型 | 正方形 | 與 M 型類似,但不會主動阻斷輸入訊號。請參閱操作手冊以確認確切的延遲時間。 |
CxpCamera, LineBuffer的狀態,以及 DmaToPC 是 M 類型運算子。 ScaleByN 和 ShiftRight 是 O 類型運算子。儘管 DmaToPC 是 M 類型,但它在此範例中不會增加大量的演算法延遲 — 資料一到達,它就會將資料傳遞給 DMA。影像在主機軟體中可見之前所需的時間是另一個稍後的延遲。
關鍵詞
您可以將 O 類型運算子視為具有固定長度的短管段。您可以將 M 類型運算子視為可能包含儲存槽(緩衝區)或更複雜機制的區段。第一滴水流出之前,儲存槽必須先填滿 — 這就是基於行的延遲。這些管線與儲存槽是 FPGA 上的硬體階段,由您在 VisualApplets 中放置的模組所產生。
Parallelism 與延遲#
Parallelism 並不會消除延遲。它會增加頻寬:每個時脈週期內,透過鏈路的像素數量會增加。
範例:當並行度為 4 時,一個時脈週期內會有四個像素通過一個連結。該 第一個像素 一個幀仍需相同的運算延遲,例如,在 ImageBuffer中的一行。在管線填滿後,四個新像素可以在每個時脈週期離開運算子。
- 高並行度→ 高吞吐量(頻寬)。
- 緩衝區與演算法→ 第一個像素的延遲。
這兩項特性是相互獨立的。VisualApplets 的設計旨在使所生成的 FPGA 管線具備高頻寬與最低延遲。
尋找運算子的延遲值#
若要尋找您要在設計中使用的運算子的延遲值,請使用以下來源:
- 運算子參考手冊— 每個運算子皆在《運算子參考手冊》中記載其延遲(或處理延遲)。
- 產品內建說明— 在設計中選取運算子,即可開啟說明以查看參數與時序的詳細資訊。此內容與《運算子參考手冊》相同,並以工具內建說明的形式提供於VisualApplets 中。
特別是對於 M 類型運算子,請務必檢查文件。延遲可能會取決於 Property(例如濾波器運算子中的核心大小,或 Memory 運算子中的緩衝區深度)。
大多數運算子不會儲存完整的影像。只要資訊可用且輸出未被封鎖,它們就會計算輸出結果。這就是為什麼產生的 FPGA 管線中的延遲能保持接近所選演算法的理論最小值的原因。
如果輸出遭到阻塞(例如,因為電腦無法以足夠快的速度接收資料),緩衝區的填滿程度就會增加,而像素出現在主機所需的時間也會隨之延長。這種額外的延遲並非固定的運算員延遲——它源自於負載下的流量控制與緩衝機制。
相關主題#
- 「管線概念」教學主題 — 無緩衝流量與並行處理
- Parallelism 教學主題 — 並行處理與延遲
- 運算子類型與同步教學主題 — 運算子類型與延遲
- 《記憶體元件》教學主題 — 緩衝運算子的行延遲
- 《核心操作教學》主題 — 與核心相關的延遲
- 使用手冊中關於 Applet 的頻寬— 頻寬與延遲的比較
- 運算子參考— 各運算子的延遲值
- 裝置資源— 基本設計時脈頻率