
下列清單顯示此 VisualApplets 版本所有支援硬體平台的。 有關詳細清單,請參閱各產品的資料表。
| 資源 | imaFlex CXP-12 Quad | imaFlex CXP-12 Penta | imaFlex 2 Dual 100 | ||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Vision Processor | Xilinx UltraScale+ XCKU3P-FFVD900-1-E | Xilinx UltraScale+ XCKU3P-FFVB676-1-E | Xilinx UltraScale+ XCKU15P-FFVE1517-1-E | ||||||||||
| LUT | 160679 | 161049 | 447992 | ||||||||||
| Flip-Flop | 323224 | 323216 | 895984 | ||||||||||
| Block RAM (18k) | 720 | 720 | 1776 | ||||||||||
| URAM Blocks (288k) | 48 | 48 | 128 | ||||||||||
| Embedded Arithmetic Logic Unit (DSP48) | 1368 | 1368 | 1800 | ||||||||||
| RAM size | 3 x 512 MiB DDR4 | 5 x 512 MiB DDR4 | 2 @ 5 x 1024 MiB DDR4 | ||||||||||
| RAM Data Width | 384 Bit | 640 Bit | 640 Bit | ||||||||||
| RAM Bandwidth total (shared) | 14.4 GB/ |
24.0 GB/s |
2 @ 24.0 GB/s |
||||||||||
| Base Design Clock (default) | 312.5 MHz |
312.5 MHz |
391.5 MHz |
||||||||||
| Base Design Clock (maximal) | 400.0 MHz | 400.0 MHz | 420.0 MHz | ||||||||||
| 主機介面 | PCIe x 8 Gen 3 (直接記憶體存取) | PCIe x 8 Gen 3 (直接記憶體存取) | PCIe x 16 Gen 3 (直接記憶體存取) | ||||||||||
| 主機介面 (PCIe x 8 Gen 3) 頻寬 (理論值) | 8000 MB/s | 8000 MB/s | 16000 MB/s | ||||||||||
| 主機介面 (PCIe x 8 Gen 3) 頻寬 (典型值/最大值) | 7200 MB/s 持續資料頻寬 | 7200 MB/s 持續資料頻寬 | 13000 MB/s 持續資料頻寬 |
||||||||||
|
|||||||||||||
表 68. imaFlex 平台硬體組態
| 資源 | mE5 marathon VCX-QP | mE5 marathon VCL | mE5 marathon VCLx | ||||
|---|---|---|---|---|---|---|---|
| Vision Processor | Xilinx Kintex7 XC7K160T - 2FFG676C FPGA | Xilinx Kintex7 XC7K160T - 1FBG676C FPGA | Xilinx Kintex7 XC7K410T - 1FBG676C FPGA | ||||
| LUT | 101400 | 101400 | 254200 | ||||
| Flip-Flop | 202800 | 202800 | 508400 | ||||
| Block RAM (18k) | 650 | 650 | 1590 | ||||
| Embedded Arithmetic Logic Unit (DSP48) | 600 | 600 | 1540 | ||||
| RAM size | 4 x 512MiB DDR3 | 4 x 512MiB DDR3 | 4 x 512MiB DDR3 | ||||
| RAM Data Width | 512 Bit | 256 Bit | 256 Bit | ||||
| RAM Bandwidth total (shared) | 12.8 GB/s |
6.4 GB/s |
6.4 GB/s |
||||
| Base Design Clock (default) | 125MHz | 125MHz | 125MHz | ||||
| Base Design Clock (maximal) | 312.5 MHz |
312.5 MHz |
312.5 MHz |
||||
| 主機介面 | PCIe x 4 Gen 2 (Direct Memory Access) | PCIe x 4 Gen 2 (Direct Memory Access) | PCIe x 4 Gen 2 (Direct Memory Access) | ||||
| 主機介面 (PCIe x 4 Gen 2) 頻寬 (理論值) | 1x2000 MB/s | 1x2000 MB/s | 1x2000 MB/s | ||||
| 主機介面 (PCIe x 4 Gen 2) 頻寬 (典型值/最大值) | 高達 1800 MB/s 的持續資料頻寬 | 高達 1800 MB/s 的持續資料頻寬 | 高達 1800 MB/s 的持續資料頻寬 | ||||
|
|
|||||||
表 69. 硬體組態 microEnable 5 marathon
每個硬體平台上的裝置資源皆有限。 以下清單顯示了所有支援平台可用的資源。Operator 會消耗裝置資源, 且大多數資源執行個體只能使用一次。此規則有一些例外情況, 例如 GPI operator。在這些情況下,資源消耗會記錄在 operator 參考文件說明中。
裝置資源配置方式為
-
自動配置,
-
使用 operator 引數配置,或
-
在 Resources 對話方塊中配置。
如需詳細資訊,請參閱 'Allocation of Device Resources'。
| 資源 | imaFlex 2 Dual 100 | ||||||||
|---|---|---|---|---|---|---|---|---|---|
| Port[0] CoF Lane |
4 | ||||||||
| Port[1] CoF Lane |
4 | ||||||||
| Port[0] CoF RX Trigger Lane |
4 | ||||||||
| Port[1] CoF RX Trigger Lane |
4 | ||||||||
| Port[0] CoF TX Trigger Lane |
4 | ||||||||
| Port[1] CoF TX Trigger Lane |
4 | ||||||||
| Port[0] CoF Status Lane |
4 | ||||||||
| Port[1] CoF Status Lane |
4 | ||||||||
| Port[0] DF RX Data Lane |
4 | ||||||||
| Port[1] DF RX Data Lane |
4 | ||||||||
| Port[0] DF RX Meta Lane |
4 | ||||||||
| Port[1] DF RX Meta Lane |
4 | ||||||||
| Port[0] DF TX Data Lane |
4 | ||||||||
| Port[1] DF TX Data Lane |
4 | ||||||||
| Port[0] DF TX Meta Lane |
4 | ||||||||
| Port[1] DF TX Meta Lane |
4 | ||||||||
| Port[0] DF Green LED Lane |
4 | ||||||||
| Port[0] DF Red LED Lane |
4 | ||||||||
| Port[1] DF Green LED |
1 | ||||||||
| Port[1] DF Red LED |
1 | ||||||||
| DmaToHostPort |
5 | ||||||||
| DmaFromHostPort |
1 | ||||||||
| GPI |
16 | ||||||||
| GPO |
16 | ||||||||
| EventPort |
31 | ||||||||
| EventID |
64 | ||||||||
| User LED |
6 | ||||||||
| ImageChannel |
1024 | ||||||||
| RAM |
2 @ from 1 x 5 GiB to 8 x 625 MiB | ||||||||
|
|||||||||
表 70. imaFlex 2 Dual 100 裝置資源清單
| 資源 | imaFlex CXP-12 Quad | imaFlex CXP-12 Penta | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 相機連接埠 | 4 | 5 | ||||||||||||
| CxpStatusPort | 4 | 5 | ||||||||||||
| CxpRxTriggerPort | 4 | 5 | ||||||||||||
| CxpTxTriggerPort | 4 | 5 | ||||||||||||
| DMA | 4 | 5 | ||||||||||||
| DmaFromHostPort | 1 | 1 | ||||||||||||
| GPO |
10 OUT | 12 OUT | ||||||||||||
| GPI |
12 IN | 12 IN | ||||||||||||
| LED Ports |
6 | 6 | ||||||||||||
| SignalChannel |
4000 | 4000 | ||||||||||||
| EventPort |
32 | 32 | ||||||||||||
| EventID |
64 | 64 | ||||||||||||
| ImageChannel |
1024 | 1024 | ||||||||||||
RAM |
from 1 x 1.5 GiB to 8 x 192 MiB | from 1 x 2.5 GiB to 8 x 320 MiB | ||||||||||||
|
||||||||||||||
Table 71. List of Device Resources imaFlex CXP-12 Quad and imaFlex CXP-12 Penta
Table 72. List of Device Resources microEnable 5 marathon
imaFlex 2 Dual 100 平臺包含兩個獨立的實體 RAM 庫,每個庫的容量為 5 GiB。這些實體庫會根據 applet 中使用的基於 RAM 的 VisualApplets 運算子數量,依需求劃分為不重疊的記憶體區域。在 VisualApplets 中,這些區域會顯示為虛擬 RAM 庫。當運算子需要 RAM 時,它會保留一個虛擬 RAM 庫,該庫對應於實體 RAM 中專用的、不重疊的區域。
有關 VisualApplets 記憶體運算子的實用指南,請參閱 Memory Elements 教學主題。
在 imaFlex 2 Dual 100 平臺上,每個實體 RAM 庫最多可以定義 8 個不重疊的記憶體區域,這意味著兩個 RAM 介面共有 16 個區域。如果只有一個 RAM 運算子被分配到實體介面,它將可以使用該介面全部 5 GiB 的容量。當多個運算子共用同一個實體介面時,可用記憶體會在它們之間按比例分配。例如,如果將 8 個運算子分配到同一個介面,則每個運算子獲得 5 GiB 記憶體的 1/8,即每個運算子大約獲得 0.625 GiB。
imaFlex 2 Dual 100 上的 RAM 頻寬在連接到同一實體介面的所有運算子之間平均共用;它不專屬於任何單一運算子。
-
如果設計在一個介面上使用了所有 8 個 RAM 資源,則每個基於 RAM 的運算子將獲得大約總介面頻寬的 1/8,並根據運算子的效率因數進行調整。
-
如果僅使用一個基於 RAM 的運算子,它就可以使用該介面的全部最大頻寬。
-
如果兩個運算子共用同一個介面,每個運算子將獲得總頻寬的一半,以此類推。
平臺的 2 個實體 RAM 介面在 VisualApplets 中被對應到 16 個虛擬 RAM 連接埠。第一個 RAM 介面對應到 RAM 資源索引 0 到 7,第二個對應到 RAM 資源索引 8 到 15。
未分配(因此未被使用)的 RAM 連接埠始終獲得 0% 的記憶體容量。這意味著總可用記憶體僅在主動使用 RAM 連接埠的運算子之間進行分配。
-
如果僅使用 1 個連接埠:該連接埠獲得 100% 的可用記憶體。
-
若使用 2 個連接埠:每個連接埠會獲得可用記憶體的 50%。
-
若使用 3 個連接埠:資源 ID 最低的連接埠獲得 50%,其餘 2 個連接埠各獲得 25%。
-
若使用 4 個連接埠:全部 4 個連接埠各獲得 25%。
-
若使用 5 個連接埠:前 3 個連接埠(資源 ID 最低者)各獲得 25%,其餘 2 個連接埠各獲得 12.5%。
-
若使用 6 個連接埠:資源 ID 最低的 2 個連接埠各獲得 25%,其餘 4 個連接埠各獲得 12.5%。
-
若使用 7 個連接埠:資源 ID 最低的連接埠獲得 25%,其餘 6 個連接埠各獲得 12.5%。
-
若使用 8 個連接埠:所有連接埠各獲得 12.5%。
 |
非對稱記憶體配置 |
|---|---|
|
在進行非對稱大小分割的情況下,處於同一實體記憶庫中且 RAM 索引最低的連接埠會獲得較大的配置比例。例如,若使用了 3 個 RAM 連接埠(0、1 和 2),則連接埠 0 會獲得 50% 的 RAM 大小,而連接埠 1 和 2 則各獲得 25%。如果連接埠為 8、9 和 10,情況也是如此,因為它們會對應到第二個 RAM 介面,但仍屬於同一個實體 RAM 庫。 |
RAM 索引不需要是連續的;其絕對順序決定了配置。RAM 索引是一個虛擬識別碼,不會影響 FPGA 資源使用率,即使序列中存在間隙也是如此。例如,若使用 3 個 RAM 連接埠(1、5 和 7):連接埠 1 獲得 50% 的 RAM 大小,連接埠 5 和 7 則各獲得 25%。
當所有資源都對應到同一個實體記憶庫時,RAM 索引的配置方式並沒有優劣之分。您可以使用 VisualApplets 提供的自動配置,或者如果某個特定的設計運算子需要比其他運算子更多的 RAM,也可以手動進行調整。
|
獨立的 RAM 介面 |
|---|---|
|
兩個實體 RAM 介面完全獨立。例如,若使用兩個運算子,且其中一個指定給第一個 RAM 介面,另一個指定給第二個介面,則每個運算子都可以充分利用其各自介面的完整最大 RAM 大小。 |
共用記憶體控制器使用循環配置(Round-robin)演算法,在實體 RAM 介面內的所有已配置連接埠之間平均分配頻寬。此演算法基於以點數為基礎的仲裁機制。當連接埠變為作用中狀態時,只要它持續提供新的 RAM 作業,就會在設定的點數時脈週期內保持作用中狀態。如果作用中的連接埠沒有更多作業,它就會停用,並且啟用權杖會移至具有待處理要求的下一個連接埠。這可確保頻寬絕不會浪費在閒置的連接埠上。
點數值是由韌體在小程式合成期間根據所使用的 RAM 運算子數量進行程式化設定的。它們無法在執行階段或透過 Framegrabber SDK 進行變更。使用者無法存取點數設定。
當連接埠處於作用中狀態時,它擁有 100% 的記憶體控制器頻寬。如果實體記憶庫中的所有 8 個連接埠都均勻保持作用中狀態,則每個連接埠隨著時間推移大約會獲得總頻寬的 1/8。在其他情況下,實際的平均頻寬取決於每個連接埠的負載。
實體 RAM 介面完全獨立。將基於 RAM 的運算子指定給不同的介面可將頻寬效率最大化。頻寬僅在連接至同一實體 RAM 介面的運算子之間共用。
imaFlex CXP-12 Quad 和 imaFlex CXP-12 Penta 平台僅組裝了一個實體 RAM 庫(其大小因平台而異)。這個單一實體庫會根據小程式內部所使用的基於 RAM 的 VisualApplets 運算子數量,動態格式化為不重疊的區域。這些區域在 VisualApplets 內部表示為虛擬 RAM 庫。當運算子保留 RAM 資源時,它使用的是對應至實體 RAM 內專屬不重疊記憶體區域的虛擬 RAM 庫。在 imaFlex 平台上最多可定義 8 個不重疊的區域。當僅使用 1 個 RAM 運算子時,該運算子會獲得平台的完整 RAM 大小。每個額外運算子所配置的大小會按比例減少該運算子在同一實體介面上所擁有的空間。若使用 8 個運算子,每個運算子將會配置平台記憶體大小的 1/8。
然而,RAM 頻寬是在設計中所有基於 RAM 的運算子之間共用的。當設計利用所有 8 個 RAM 資源時,8 個基於 RAM 的運算子中的每一個都可以擁有高達 1/8 GB/s 的專屬頻寬,再減去該特定運算子的效率係數。當設計中僅使用一個基於 RAM 的運算子時,該運算子會獲得平台的總頻寬。當使用 2 個運算子時,這兩個運算子各自獲得總頻寬的一半,以此類推。
未配置且因此未使用的 RAM 連接埠一律獲得 0% 的記憶體大小。
-
使用 1 個連接埠:使用的連接埠獲得 100%。
-
使用 2 個連接埠:兩個使用的連接埠各獲得 50%。
-
使用 3 個連接埠:資源 ID 號碼最低的連接埠將獲得 50%,其餘 2 個使用的連接埠各獲得 25%。
-
使用 4 個連接埠:全部 4 個連接埠各獲得 25%。
-
使用 5 個連接埠:資源識別碼編號最低的 3 個連接埠將獲得 25%。最後 2 個連接埠將獲得 12.5%。
-
使用 6 個連接埠:資源識別碼編號最低的 2 個連接埠將獲得 25%。其餘 4 個連接埠將獲得 12.5%。
-
使用 7 個連接埠:資源識別碼編號最低的連接埠將獲得 25%。其餘 6 個連接埠將獲得 12.5%。
-
使用 8 個連接埠:所有連接埠均獲得 12.5%。
|
|
|
在非對稱大小磁區分割的情況下,RAM 索引較低的連接埠將獲得較大的配置。例如,使用 3 個 RAM 連接埠:0、1、2。連接埠 0 獲得 50% 的 RAM 大小配置。連接埠 1 和 2 各獲得 25%。 RAM 索引不需要是連續的,其絕對順序決定了配置。當排序中出現間隙時,RAM 索引是一個虛擬數字,對 FPGA 資源使用沒有影響。例如,使用 3 個 RAM 連接埠:1、5、7。連接埠 1 獲得 50% 的 RAM 大小配置。連接埠 5 和 7 各獲得 25%。 配置運算子的 RAM 索引沒有優缺點。當特殊設計運算子需要比其他運算子更多的 RAM 大小時,可以使用 VisualApplets 自動配置或手動調整。 |
共用記憶體控制器採用循環配置演算法 (Round-robin algorithm),並將頻寬平均分配給所有已配置的連接埠。該演算法使用信用仲裁機制 (credits arbitration scheme):當連接埠變為作用中狀態時,只要該連接埠提供新的 RAM 作業,它就可以在信用的時脈週期內保持作用中狀態。一旦某個連接埠被啟用但不再有作業,該連接埠就會被停用,並且啟用權杖會跳到排隊中的下一個有要求作業暫掛的連接埠。透過這種方式,頻寬絕不會在閒置時浪費。信用完全由韌體在 applet 合成期間根據使用的 RAM 運算子數量專門編程,無法在 Framegrabber SDK 中或執行階段進行更改。使用者無法存取信用的編程。當作用中連接埠擁有 RAM 介面時,它將能夠存取記憶體控制器的 100% 頻寬。當全部 8 個連接埠都被使用且均勻處於作用中狀態時,隨時間產生的頻寬對每個連接埠來說是 1/8。在所有其他情況下,連接埠上的負載決定了每個連接埠的實際平均頻寬。
microEnable 5 marathon 平台僅組裝了一個實體 RAM 銀行(其大小因平台而異)。這個單一的實體銀行被格式化為 4 個不重疊的記憶體區域。這 4 個區域在 VisualApplets 內部表示為 4 個虛擬 RAM 銀行。當運算子預留 RAM 資源時,它使用的是對應到實體 RAM 內互不重疊的專用記憶體區域的虛擬 RAM 銀行。
然而,RAM 頻寬在設計中的所有基於 RAM 的運算子之間共用。當設計使用所有 4 個 RAM 資源時,4 個基於 RAM 的運算子中的每一個都可以擁有高達 1.6 GB/s 的專用頻寬,減去該特定運算子的效率因數。當設計中僅使用一個基於 RAM 的運算子時,該運算子獲得 6.4 GB/s 的總頻寬。當使用 2 個運算子時,兩個運算子中的每一個都獲得總頻寬的一半,依此類推。
|
每個運算子的頻寬 |
|---|---|
|
板載 RAM 提供 6.4 GB/s 的總頻寬。單個基於 RAM 的運算子可用的頻寬是總頻寬除以設計中所有已實例化的基於 RAM 的運算子的數量。 |
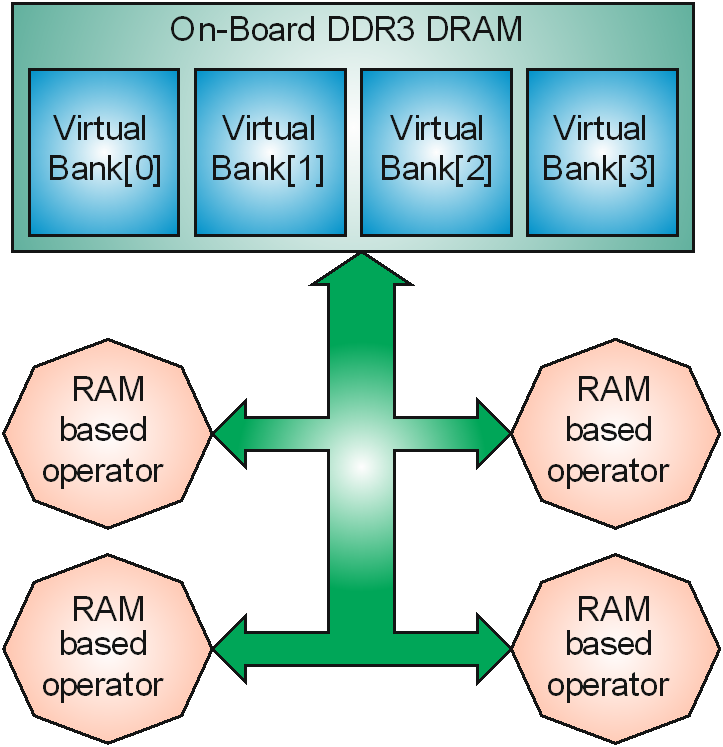
使用基於 RAM 的運算子進行設計時,需要考慮此 RAM 架構。
由於共用頻寬架構,當使用多個基於 RAM 的運算子時,applet 開發人員應利用運算子記憶體介面的全部 256 位元 (RAM Data Width) 來透過記憶體介面實現最大吞吐量,即使單個 RAM 運算子在其輸入端需要的頻寬較少。
imaFlex 2 Dual 100 提供 2 個光纖 QSFP28 連接器:C0 與 C1。
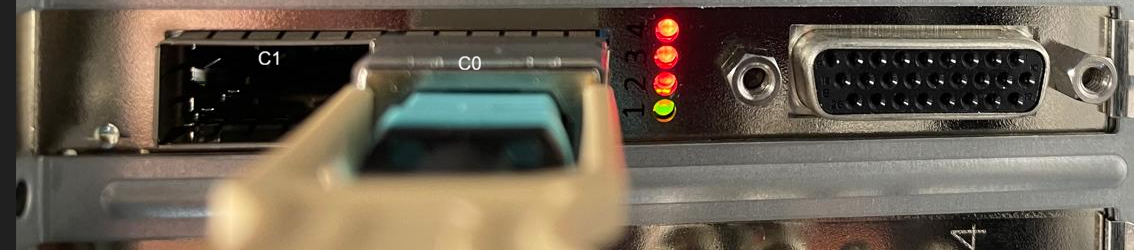
兩個連接器皆支援 CoF (CXP over Fiber) 與資料轉發協定。每個光纖連接器都有自己的 LED:四個 LED 分配給連接器 C0,一個 LED 分配給連接器 C1。
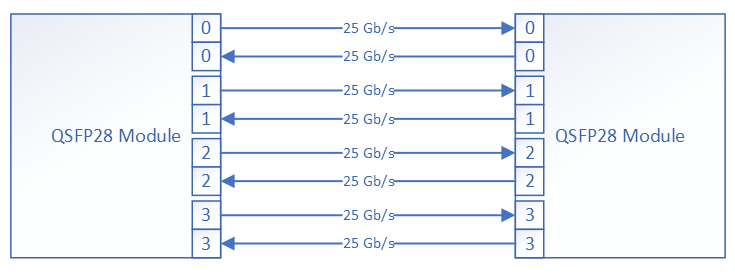
每個連接器都支援 QSFP28 光學模組。QSFP28 介面在兩個方向上提供 4 個光纖連接,即 4 個 RX 和 4 個 TX 連接。在運算子文件中,光纖連接被稱為 lane。每個 QSFP28 連接埠在 RX 和 TX 方向都有 4 個光纖 lane,標記為 0 到 3。每個 lane 的運作速度為 25 Gbit/s。因此,單個 QSFP28 連接器可以在 TX 和 RX 方向傳輸 100 Gbit/s 的累積頻寬。
imaFlex 2 Dual 100 提供資料轉發功能,可在多個擷取卡之間雙向傳輸資料。VisualApplets 中的資料轉發支援各種拓撲以傳輸資料和中繼資料,包括菊鏈 (daisy-chain) 和更先進的模型。資料轉發行為完全由使用者透過 VisualApplets 運算子控制。相機資料、applet 產生的資料和中繼資料可以在 TX 和 RX 方向獨立傳輸。VisualApplets 還會對 lane 進行多工處理,允許中繼資料和常規影像資料透過兩個獨立的虛擬通道同時在單個光纖 lane 上傳送。中繼資料具有優先順序,以確保及時交付。
由於光纖技術支援雙向通訊,先進的主從 (master-slave) 應用可以讓主裝置控制從裝置接收哪些資料並從中收集處理結果。在從屬 GPU 或 CPU 上產生的處理結果可以透過 DmaFromPC 傳回,然後透過資料轉發資料運算子轉發回主擷取卡。
在典型的資料轉發菊鏈式(daisy-chain)組態中,所選的相機資料會被轉發至多個擷取卡。接著,這些擷取卡會透過 PCIe 以極低的延遲將資料傳輸至外部 GPU。
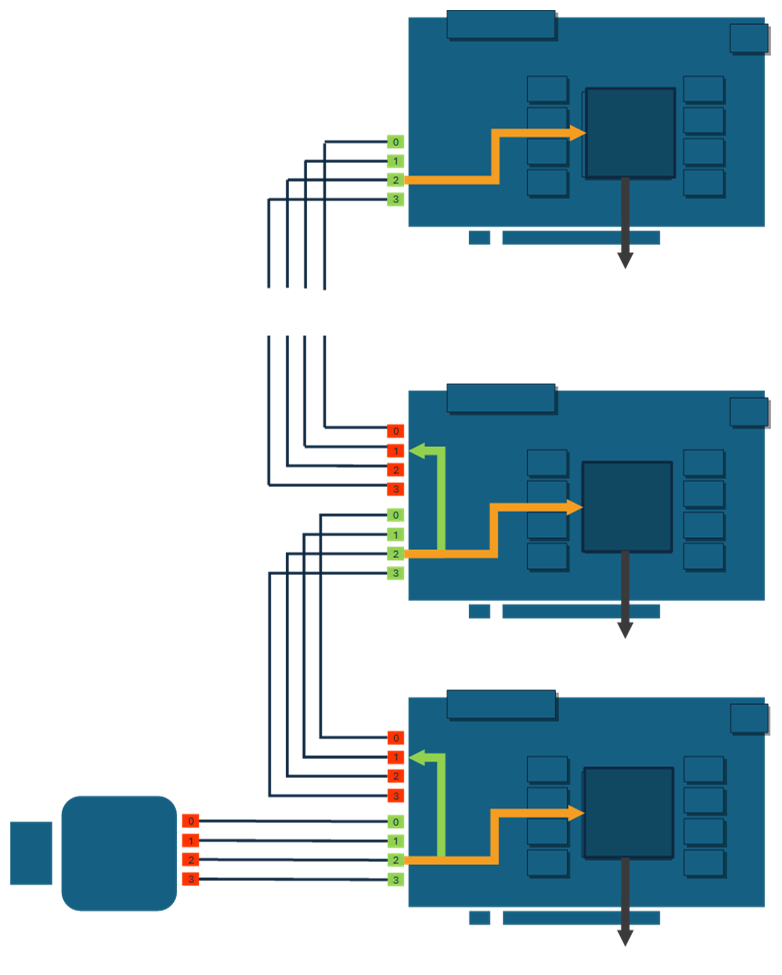
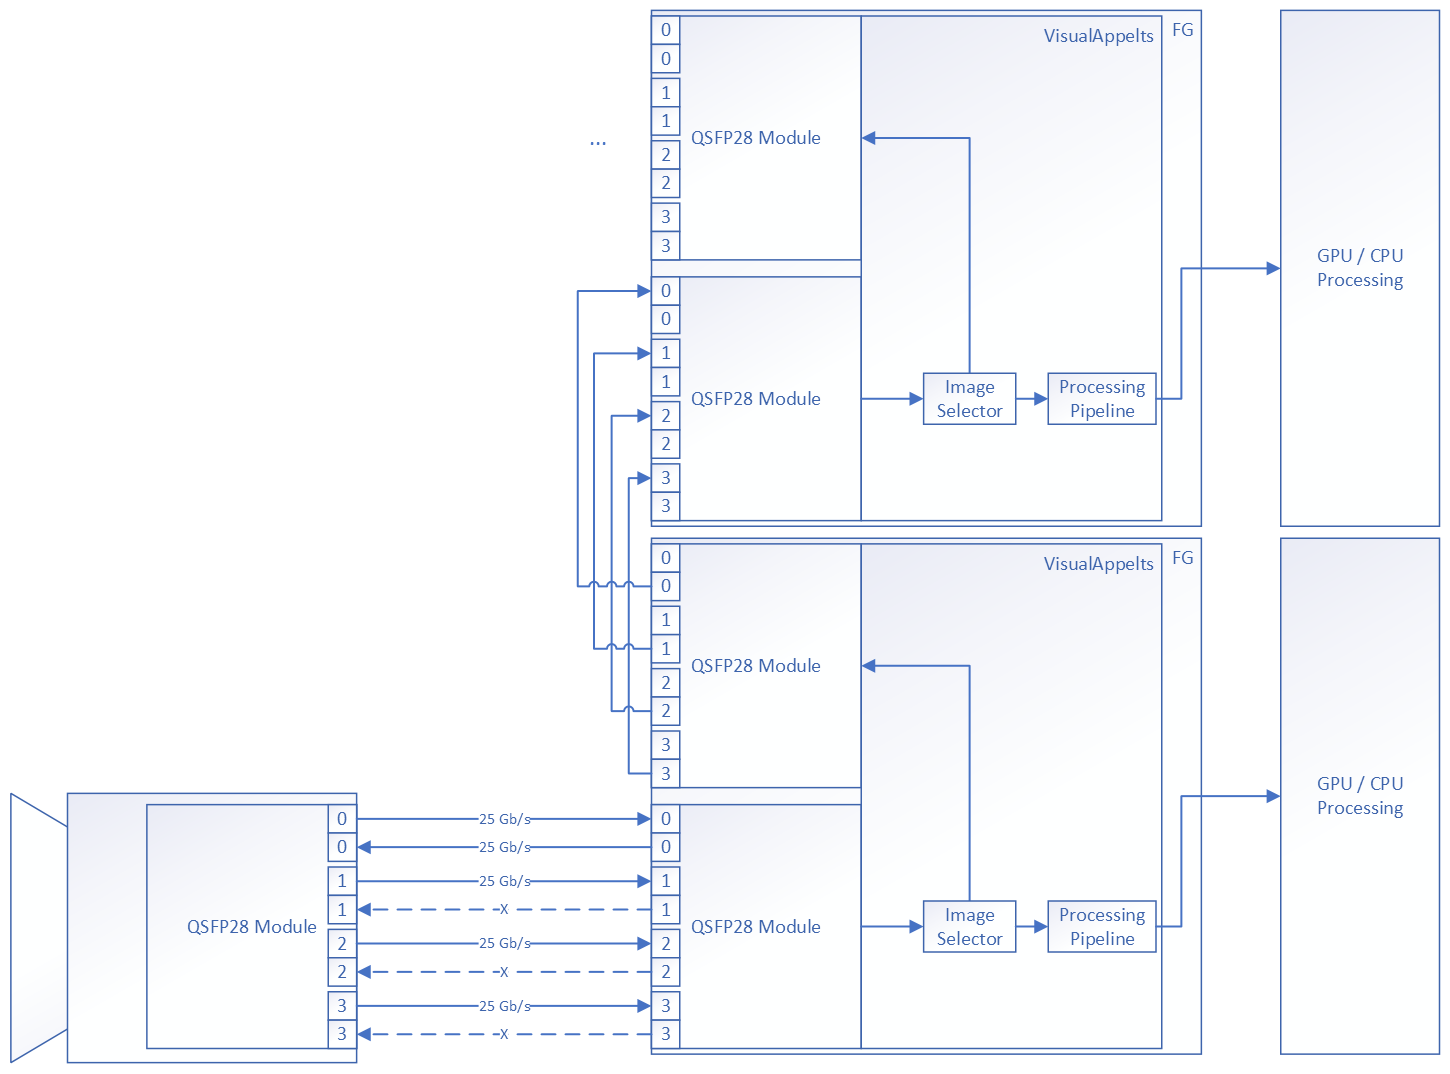
CoF (CXP over Fiber) 使用四個下行連接和一個上行連接。兩個擷取卡之間的資料轉發鏈路經過組態,僅傳輸所需的資料;它們不傳輸原生的 CoF 流量,而是承載 VisualApplets 資料與中繼資料串流。CoF 與資料轉發均受到前向錯誤更正 (FEC) 的保護。
主擷取卡連接至相機,並將選定的資料部分轉發至下一個從擷取卡。每個從擷取卡會擷取其自身處理所需的資料,並將影像串流中其餘未處理的部分轉發給序列中的下一個從裝置。鏈路中的最後一個擷取卡作為端點,不再進一步轉發任何資料。
上述範例是菊鏈式拓撲的簡化表示。在更進階的組態中,兩個連接的擷取卡可以自由交換資料:它們可以在彼此之間跨越 1、2、3 或 4 條通道連接。RX 和 TX 方向可以使用不同數量的通道。
多條光纖通道可以組合成虛擬通道,允許透過單一 QSFP28 連接器傳輸多個資料通道。除了影像資料傳輸外,VisualApplets 還為每條光纖通道提供專屬的中繼通道(meta channel)。此中繼通道優先於一般影像資料,並以極低的抖動與延遲進行傳輸,使應用程式能夠實現時間戳記與機板對機板同步。小型旁頻(side-band)資訊也可以透過中繼通道傳輸,例如用於組態光纖連接另一端的從屬夥伴。夥伴可以透過其自己的中繼通道將控制與狀態資訊回傳給主裝置。每個擷取卡還可以高達 100 Gb/s 的總頻寬將處理後的影像資料傳送給其夥伴。
透過單一 QSFP28 介面,最多可在兩個擷取卡之間跨越四個中繼通道,在 TX 和 RX 方向上皆可獨立運作。每個中繼通道的運作速率為 25 Gb/s。影像資料通道可以跨越 1、2、3 或 4 條光纖通道,以形成虛擬資料傳輸通道。
QSFP28 資料轉發介面允許以下虛擬資料通道組合:
-
1 x4 通道:100 Gbit/s
-
1 x3 通道(執行速率為 75 Gbit/s)與 1 x1 通道(執行速率為 25 Gbit/s)
-
2 x2 通道(各自執行速率為 50 Gbit/s)
-
1 x2 通道(執行速率為 50 Gbit/s)與 2 x1 通道(各自執行速率為 25 Gbit/s)
-
4 x1 通道(各自執行速率為 25 Gbit/s)
RX 和 TX 側完全獨立運作。這意味著可以根據需要實作或省略反向 (RX) 方向。如果實作了該方向,則它不需要與正向 (TX) 方向對稱。
中繼通道與資料通道獨立運作。每個中繼通道使用剛好一條光纖通道,且執行速率為 25 Gb/s。中繼通道專為傳輸少量資料而設計。由於它們具有優先權,因此中繼通道傳輸會暫時中止同一光纖通道上的一般資料傳輸。
為了支援資料轉發功能,VisualApplets 提供了以下運算子:
Basler 提供作為 VisualApplets 設計的資料轉發範例,以及 C++ SDK 控制應用程式。在這些範例中,您可以了解如何使用這些運算子進行資料轉發。這些範例作為 VisualApplets 範例提供於 Examples/Acquisition/DataForwarding您可以在以下主題中找到這些資料轉發範例的相關文件: 'Data Forwarding for CoaXPress over Fiber Frame Grabber' 主題位於 基礎與範例.
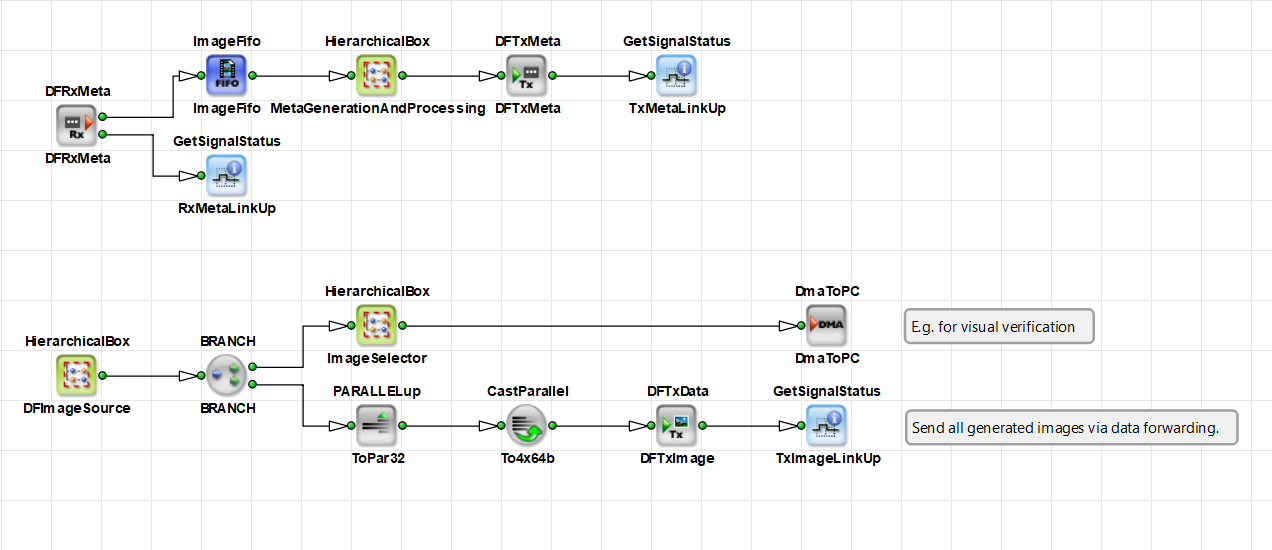
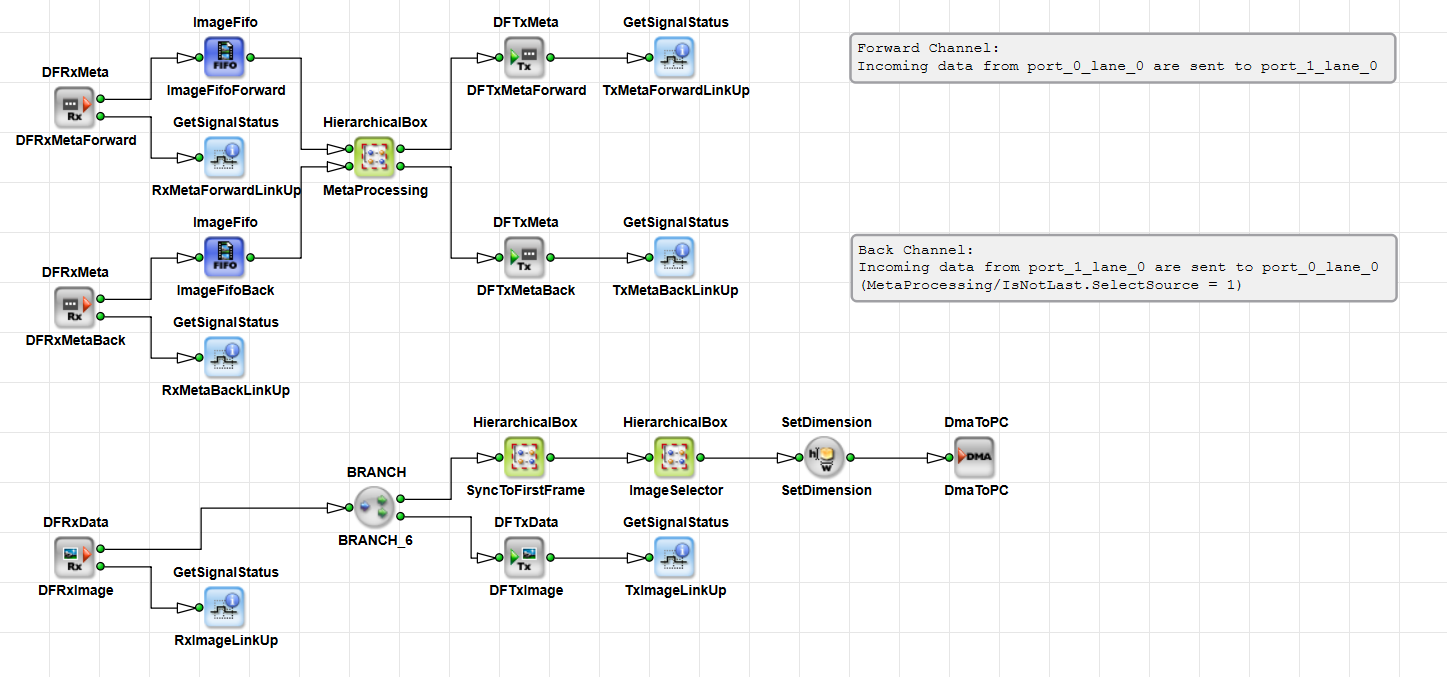
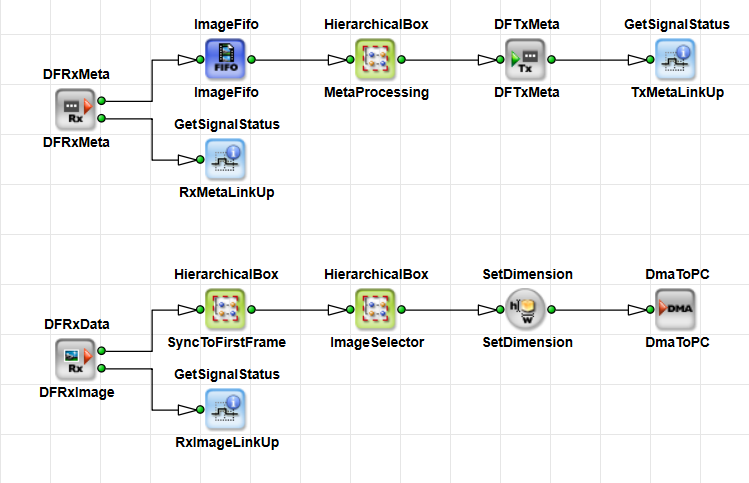
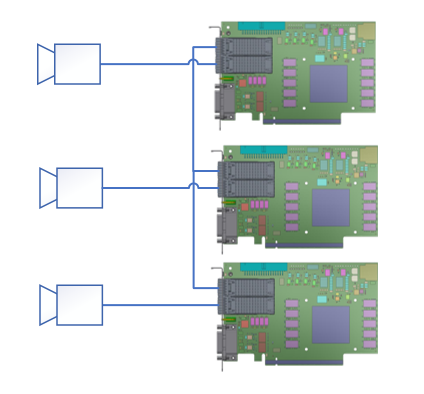
在某些限制條件下,更複雜的相機與擷取卡組合模型是可行的。 兩個擷取卡之間的光學傳輸具有極低的延遲: 資料字從一個擷取卡傳輸到另一個擷取卡大約只需 120 ns。
菊鏈 (Daisy-chain) 架構是將處理負載分配到多個 CPU/GPU 叢集的最常見方法:
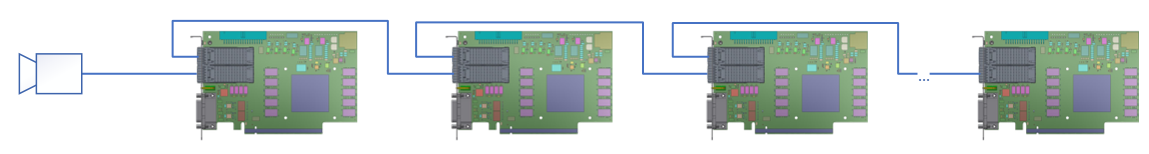
主擷取卡連接至相機;第二個 QSFP28 連接埠連接至下一個從屬裝置。每個從屬裝置會處理部分輸入資料,並將剩餘資料轉發至下一個裝置。鏈結中的最後一個擷取卡作為端點。除了最後一個之外,所有擷取卡皆會使用兩個 QSFP28 連接埠。
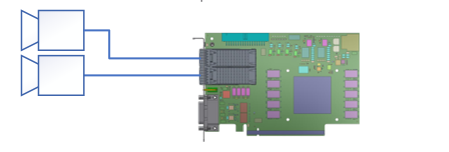
對於某些應用,可以將兩部 100‑Gb/s 相機連接至單一擷取卡。這要求相機未以最大頻寬運行,或者可以在將資料儲存到 RAM 之前透過 VisualApplets 執行預先處理,以稍微降低頻寬,使兩個相機串流都能放入兩個 RAM 介面中。在此組態下,擷取卡必須在 VisualApplets 中執行額外的處理,以降低產生的資料速率,使其符合大約 13 GB/s 的有限 PCIe 傳輸量。
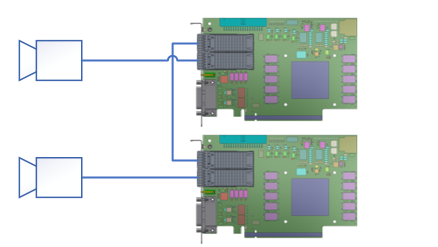
在此情況下,每個擷取卡連接至其自己的相機。第二個 QSFP28 連接埠用於擷取卡之間的通訊,在兩個方向上實現高達 100 Gbit/s 的資料交換,以進行複雜的運算任務與同步。
 上一頁

