處理 Kernel#
讀完本主題後,您將了解如何建置核心、使用濾波器運算子處理它,以及在...之前將其轉換回單個像素 DmaToPC.
Kernel 結構#
核心是影像中某個位置周圍相鄰像素值的小窗口。許多濾鏡(如 Noise Reduction、模糊、邊緣偵測)會從該鄰域計算出新的輸出值。
對於 3×3 kernel,視窗包含九個值:該位置的目前像素加上八個相鄰像素。對於奇數 kernel 大小,目前像素位於視窗的中心。
Kernel 會由左至右、逐列地在影像上移動。在每個位置,濾波器會使用該像素周圍的鄰域:
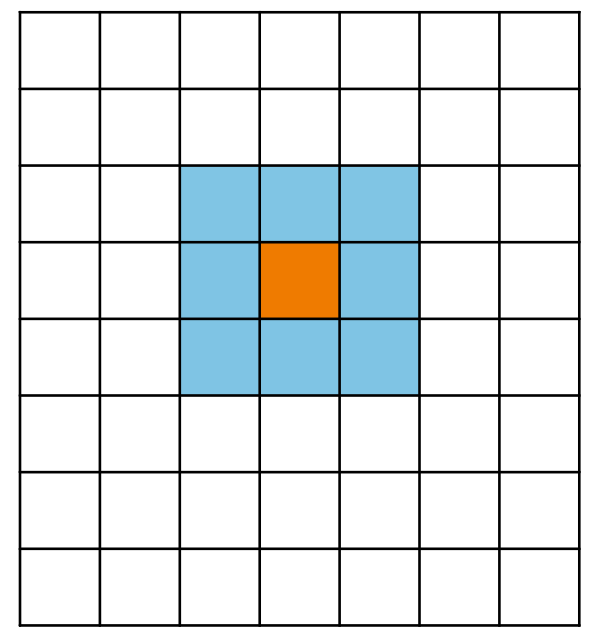
在 VisualApplets 中,該鄰域是由 link properties 所定義。如何建構視窗以及目前像素在其中的位置,取決於運算子。相關細節如下所述。
Kernel Columns 與 Kernel Rows#
Kernel 大小是 link properties. KernelColumns 是鄰域視窗的寬度。 KernelRows 是其高度。因此,3×3 核心會使用 KernelColumns = 3 且 KernelRows = 3.
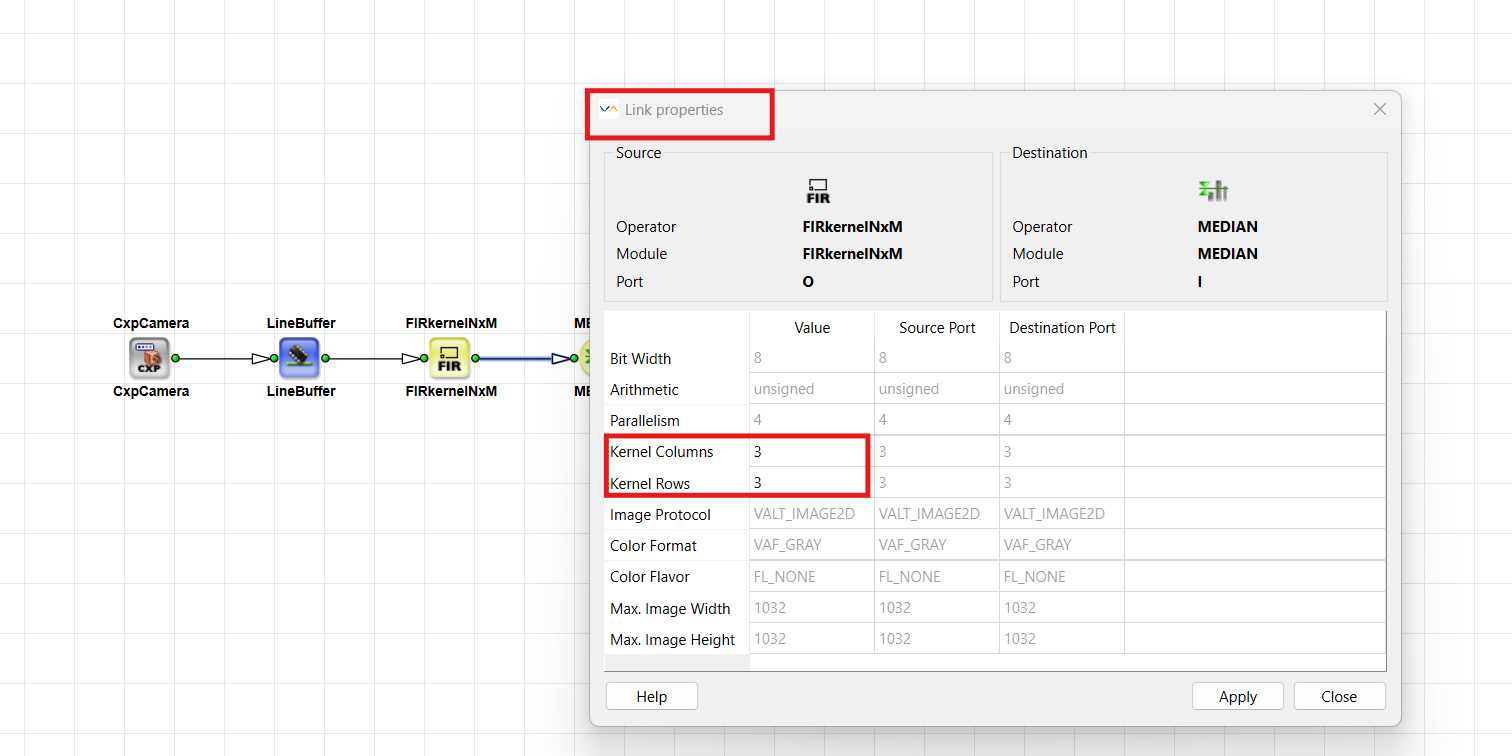
在 VisualApplets 中,N 是 kernel rows 的數量,M 是 kernel columns 的數量。Kernel 元素透過索引而非座標來定址。索引是逐列從左上角執行到右下角。
請務必查閱 operator 文件,以取得核心索引對應至影像位置的準確對應關係。
並非每個運算子都接受或轉發大於 1×1 的 kernels。每個運算子都在其 支援的 Link 格式 中的 Operator Reference中記錄了允許的值。如果您將 kernel 連線連接至僅允許 Kernel Columns = 1 和 Kernel Rows = 1的 operator,VisualApplets 會回報 link format 衝突。
如需所有 link properties 的概覽,請參閱 Parameterization 教學主題。
Kernels 與 Parallelism#
Parallelism 與 kernels 兩者都會增加連線在每個時脈週期中傳輸的資料量,但它們描述的是不同的概念:
| Parallelism | Kernel | |
|---|---|---|
| 問題 | 每個時脈通過多少個獨立像素? | 一個位置屬於多少個相鄰值? |
| 典型用途 | 匹配相機 / DMA 頻寬 | 提供需要鄰域(neighborhood)的濾波器 |
| Link properties | Parallelism | KernelColumns, KernelRows |
您可以將 Parallelism 保持為 1,並透過使用核心(kernel)在每個時脈週期中傳輸更多資料:Link 傳輸一個鄰域(例如 3×3 個值)作為一個資料字(data word)。每個時脈週期的資料量之所以增加,是因為每個時脈週期移動了更多數值,而不是因為每個時脈週期處理了更多新的影像位置。Parallelism 教學主題中的像素率頻寬公式不會乘以核心大小。
您也可以將兩者結合。Operator CastKernel 可以在輸入和輸出之間重新解譯 parallelism 與核心大小的乘積,只要該乘積保持不變即可。例如,具備核心 3×2 的 parallelism 1 可以變成具備核心 1×1 的 parallelism 6。
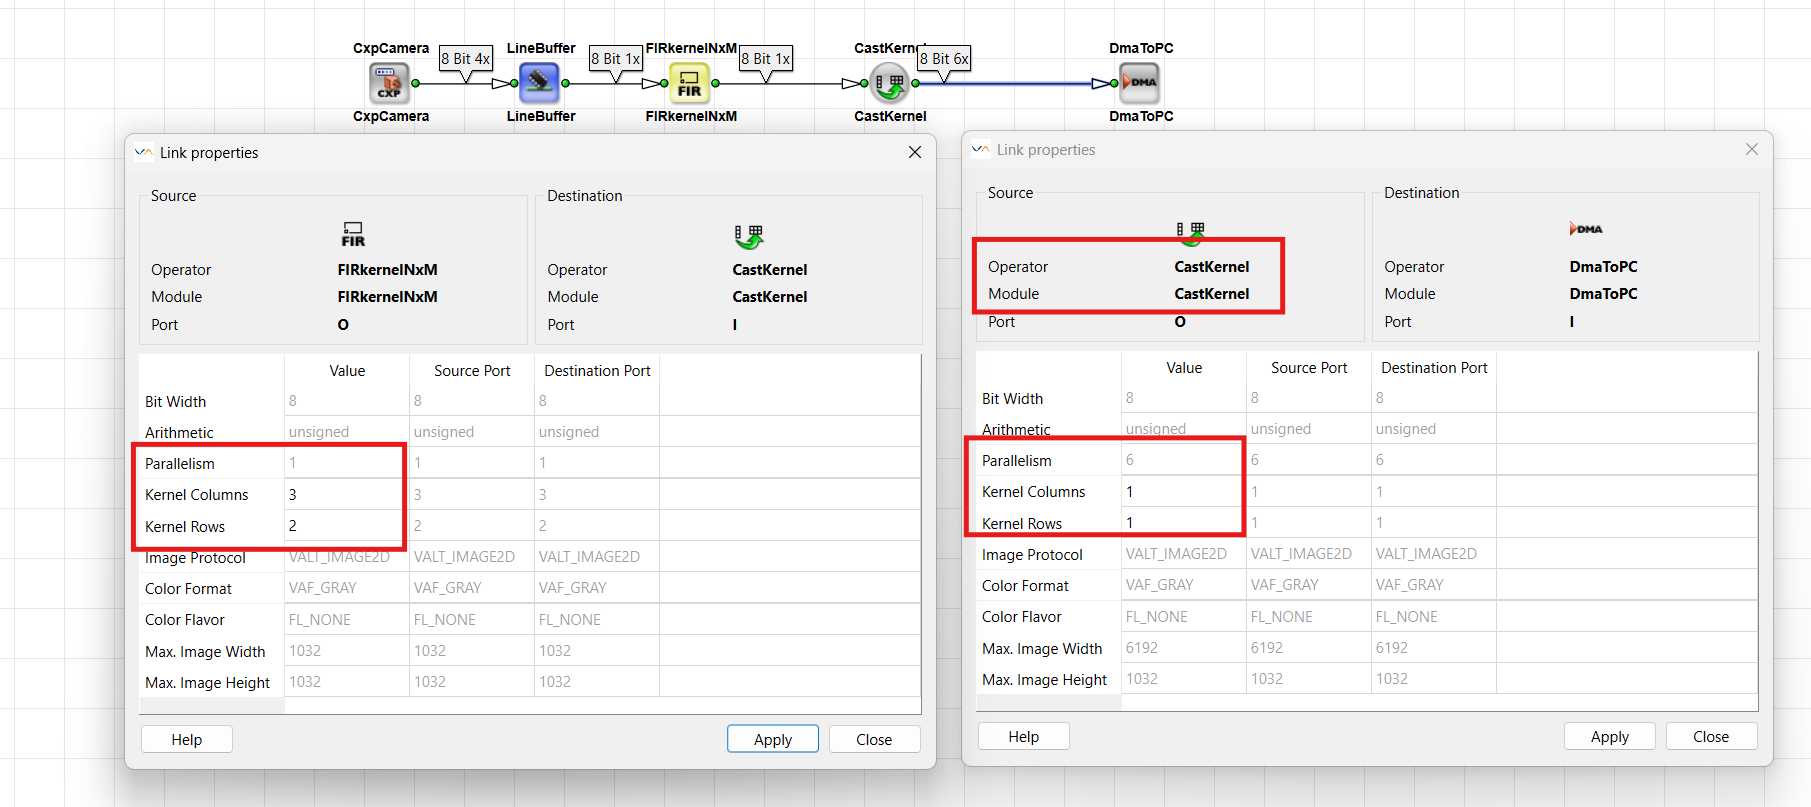
如需詳細資訊,請參閱 Operator Reference 中的 CastKernel 以及 Parallelism 教學主題。
建立 Kernels#
若要從一般像素串流建立鄰域資料,請使用在其 輸出 Link 上設定核心大小的運算子。 FIRkernelNxM 會建構置中的 2D 核心視窗。 LineNeighboursNx1 和 PixelNeighbours1xM 是特殊情況:它們收集先前的行或先前的像素,而不是置中的視窗。這些 operators 在目前像素所在位置、operator 類型、FPGA 成本與延遲以及邊緣處理(見下文)方面有所不同。請選擇符合您使用情境的 operator:置中的 2D 濾波器鄰域、跨先前行或像素的比較,或是完整 FIR 風格視窗的資源有效率替代方案。
FIRkernelNxM#
操作員 FIRkernelNxM (library Filter) 會在每個像素周圍建立矩形核心視窗,包含相鄰像素。儘管名稱如此,它並 不會 不實作 FIR 濾波器。它會準備濾波器運算子所需的核資料。對於奇數核心大小,當前像素位於 中心 。對於偶數大小的核心,沒有確切的中心;中心位置會偏向左上方。
使用 3×3 Average Filter 進行平滑處理:
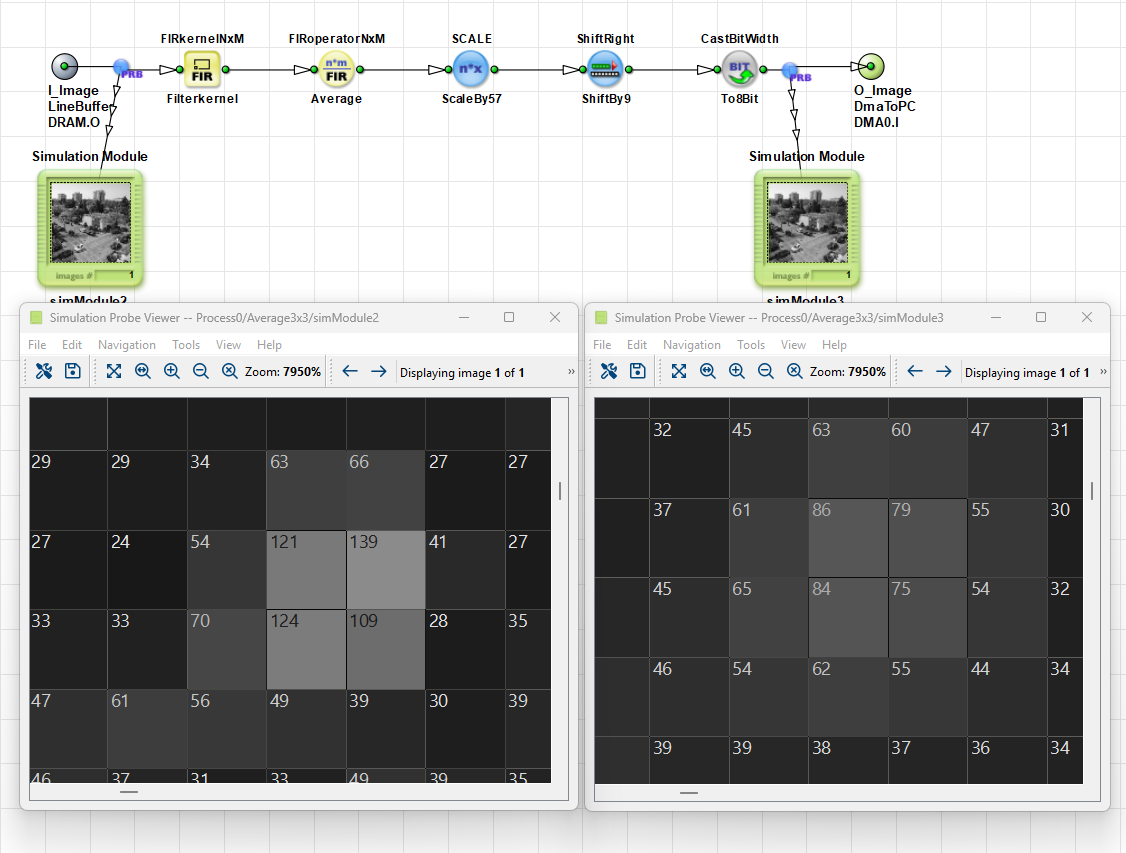
此設計會建構一個置中的 3×3 鄰域,並帶有 FIRkernelNxM (Filterkernel),將其與 FIRoperatorNxM (Average),然後將結果縮放並轉換回 8 位元。模擬探針會比較平均處理前後的像素值:原本尖銳的局部峰值會變得更平滑、更均勻。請定義
)。運算子會將所需的像素進行緩衝,直到備妥完整的鄰域。在影像邊界處,可能會缺少相鄰像素。參數Kernel Columns 和 Kernel Rows選取如何填補缺失的值( EdgeHandling 是一個 M 型運算子。建立置中的鄰域(例如 3×3)需要進行緩衝,因此與下方以行為單位或以像素為單位的鄰域運算子相比,它會消耗更多 FPGA 資源並增加更多延遲。當濾波器確實需要置中的 2D 鄰域時,請使用EdgeMirrored 或 EdgeConstant)。
FIRkernelNxM 是一個 M型 運算子。建構置中鄰域(例如 3×3)需要進行緩衝,因此比下方的行或像素相鄰運算子消耗更多 FPGA 資源並增加更多延遲。當濾波器確實需要 FIRkernelNxM 時,請使用 置中的 2D 鄰域 — 例如在 FIRoperatorNxM 如需該運算子的詳細資訊,請參閱 Operator Reference 中的 FIRkernelNxM。
關於該運算子的詳細資訊,請參閱 Operator Reference 中的 FIRkernelNxM。
LineNeighboursNx1 和 PixelNeighbours1xM#
LineNeighboursNx1 和 PixelNeighbours1xM 會建立一個包含 N 行與 1 列的核心。目前的像素位於核心索引 0;其他元素則是來自先前行(上方)的像素。
LineNeighboursNx1 會建立一個包含 N 行和 1 列的核心。當前像素位於 核心索引 0;其他元素則是來自先前行(上方)的像素。 PixelNeighbours1xM 會建立一個包含 1 行和 M 列的核心。當前像素再次位於 核心索引 0;其他元素則是同一行上的先前像素(左側)。
與...不同 FIRkernelNxM,這些運算子 不會 以當前像素為中心,且不提供尚未處理的「未來」相鄰像素。它們僅查看 過去 (先前的行或先前的像素)。它們是 O-type 運算子,不會增加因緩衝置中鄰域而產生的行或像素延遲。這使得它們比以下運算子更簡單,通常也更節省 FPGA 資源: FIRkernelNxM;這裡沒有鏡射邊緣處理。 Constant典型使用案例:
使用
-
跨以下項目比較或縮減數值: 先前的行 並使用
LineNeighboursNx1使用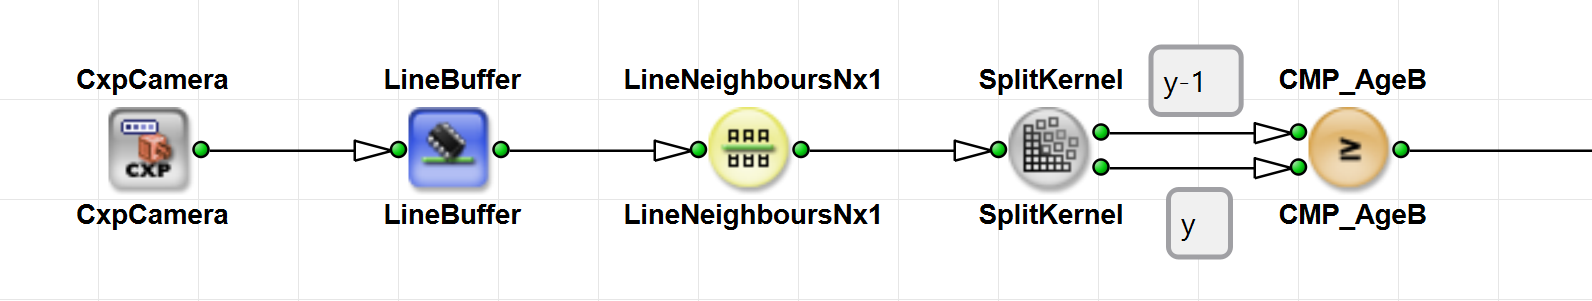
-
跨以下項目比較或縮減數值: 同一行上的先前像素 並使用
PixelNeighbours1xM.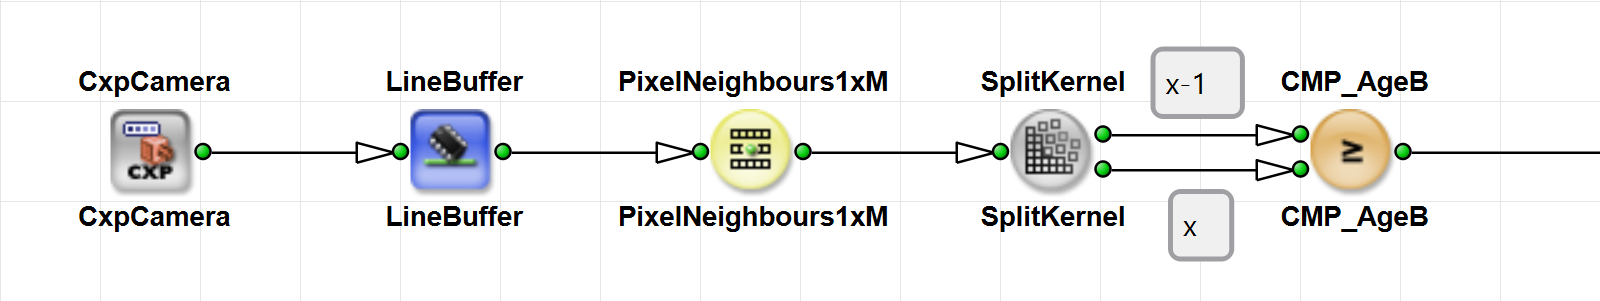
-
將資料饋送至縮減運算子(例如
MIN或MAX:這些運算子期望輸入端具有 Kernel,從鄰域中選擇一個值(例如最小的像素),並輸出 1×1 的結果。在此步驟之後,Kernel 會再次解析。相鄰行之間的最小像素值:
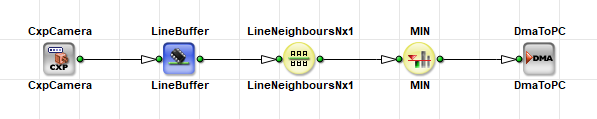
相鄰像素之間的最大像素值:
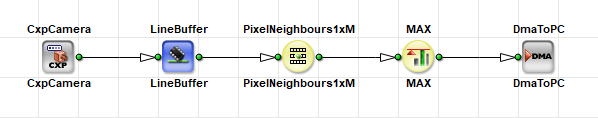
若要建立二維核心,您可以將 LineNeighboursNx1 與 PixelNeighbours1xM.
有關運算子的詳細資訊,請參閱運算子參考手冊中的 LineNeighboursNx1 與 PixelNeighbours1xM。
ExpandToKernel#
操作員 ExpandToKernel 將單一像素輸入擴展為任意 Kernel 大小。它會 複製 輸入值到每個 Kernel 元件。您可以在輸出連接上定義新的 Kernel 大小。
使用 ExpandToKernel 當下游運算子期望輸入端具有 Kernel,但您只有 單一 像素值時(例如閾值、平均值或參考像素)。常見的模式是擴展該常數或參考值,使其符合來自 FIRkernelNxM, LineNeighboursNx1或 PixelNeighbours1xM的現有鄰域。然後您可以套用運算子,例如 CMP, SUB或 ADD 在整個 Kernel 上進行逐元素運算(例如將每個相鄰像素與相同的閾值進行比較)。
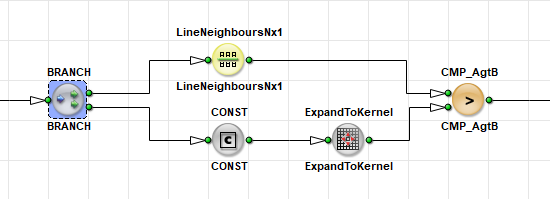
有關運算子的詳細資訊,請參閱運算子參考手冊中的 ExpandToKernel。
處理 Kernels#
建構 Kernel 後,您可以對其進行過濾、提取子集、合併或分割 Kernel 資料流,或重新排序 Kernel 元件。本節中的運算子會處理現有的 Kernel。在 DmaToPC,您必須將 Kernel 縮減為 1×1 — 請參閱 連接至 DMA.
FIRoperatorNxM#
操作員 FIRoperatorNxM 將每個 Kernel 元素與係數相乘並將乘積加總。您可以使用 Coefficients 參數的值。
運算子的輸出 FIRoperatorNxM 具有 1×1 的 Kernel 大小,這意味著每個位置有一個過濾後的像素值。請使用 FIRkernelNxM, LineNeighboursNx1或 PixelNeighbours1xM 來產生所需的輸入 Kernel。
當您在連接上已經有鄰域且每個位置需要一個過濾後的輸出像素時,請將此運算子用於傳統的 FIR 風格過濾器(平均值、高斯、Sobel 及類似過濾器):
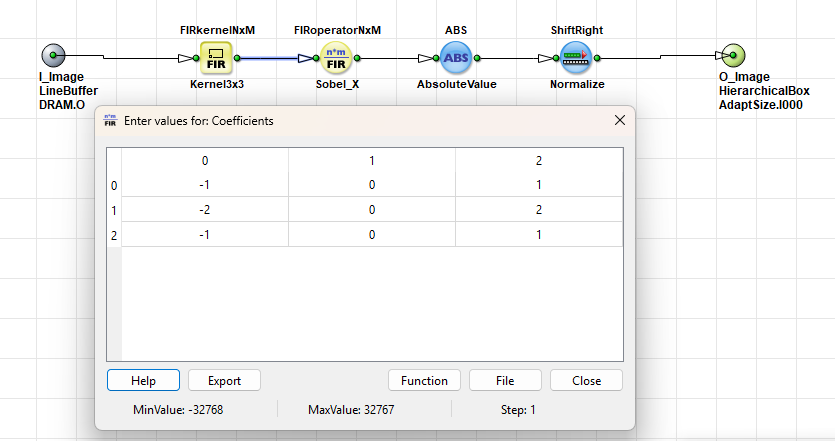
螢幕截圖顯示了 VisualApplets 附帶的設計範例 Examples\Processing\Filter\EdgeDetection\SobelGradientX。
有關該算子的詳細資訊,請參閱 Operator Reference 中的 FIRoperatorNxM。
SelectSubKernel#
影像 SelectSubKernel 運算子會提取輸入 Kernel 的矩形子集。其參數 FirstROW 和 FirstCOL 定義了子集的偏移量。新的 Kernel 大小是在輸出連接上設定的。
使用 SelectSubKernel 您擷取 核心的 中心元素(通常是該影像位置的原始像素)— 當您不再需要完整的鄰域時。
典型的使用情境是套用濾鏡並同時保留 原始 影像。在 FIRkernelNxM 建構好鄰域後,您將 Kernel 連接分岔。一條路徑計算過濾後 Resultados。另一條路徑使用 SelectSubKernel 來提取 1×1 子 Kernel —— 該影像位置的原始像素。這樣您就同時擁有了過濾後的資料和未過濾的影像。
在過濾器旁保留原始影像資料:
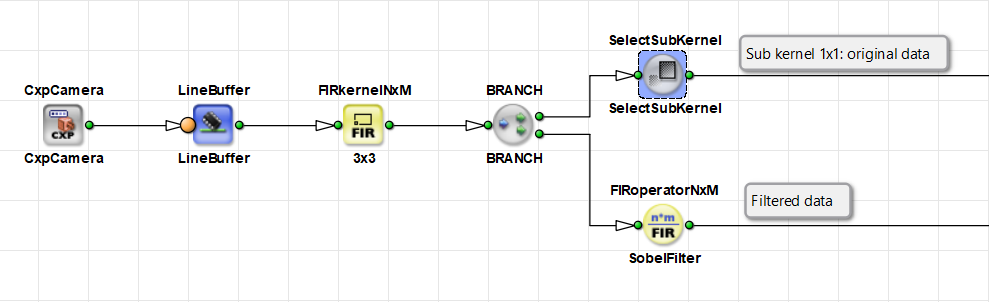
該設計使用 FIRkernelNxM建構 3×3 鄰域,然後進行分岔。上方路徑使用 SelectSubKernel 來提取原始像素(1×1 子 Kernel)。下方路徑套用 FIRoperatorNxM 作為 Sobel 過濾器。
有關該算子的詳細資訊,請參閱 Operator Reference 中的 SelectSubKernel。
MergeKernel 和 SplitKernel#
操作員 MergeKernel 將多個輸入連線合併為一個輸出 kernel。為此,所有輸入上的其中一個 kernel 維度(行或列)必須相符;輸入上的另一個維度則可以不同。 Alignment 具備以下值的參數: horizontal 或 vertical 定義了如何串接這些輸入。
相對應的 operator 是 SplitKernel. SplitKernel 將 N×M kernel 拆分為 N×M 個獨立的輸出連線,每個連線的 kernel 大小均為 1×1。輸出的數量必須等於 kernel 元件的數量,並在您執行個體化 operator 時固定。
典型的使用情境是結合 同一影像的數種變體 — 例如不同的灰階或處理版本 — 結合成一個核心,以便您可以一起比較或處理它們。使用 SplitKernel 當您需要再次在獨立路徑上處理個別的 kernel 元件時。
結合起來, MergeKernel 和 SplitKernel 也可以取代原本需要 SYNC operator 輸出 link 上的 Bit Width: SYNC 通常在其輸入端需要緩衝區,因此會消耗 FPGA 資源。當串流可以改為作為 kernel 元件傳輸時,合併與拆分 kernel 通常是更節省資源的方法。
此模式僅適用於 同一影像的數種變體 依然共用相同的來源,例如相機資料流的兩個不同處理路徑。Do 不會 使用 MergeKernel 來合併兩個獨立的相機。獨立的相機仍然是非同步來源,且依然需要 SYNC (或具有非同步輸入的其他算子)與緩衝區。請參閱 Operator 類型與同步 教學主題。
合併非同步路徑時發生同步錯誤:
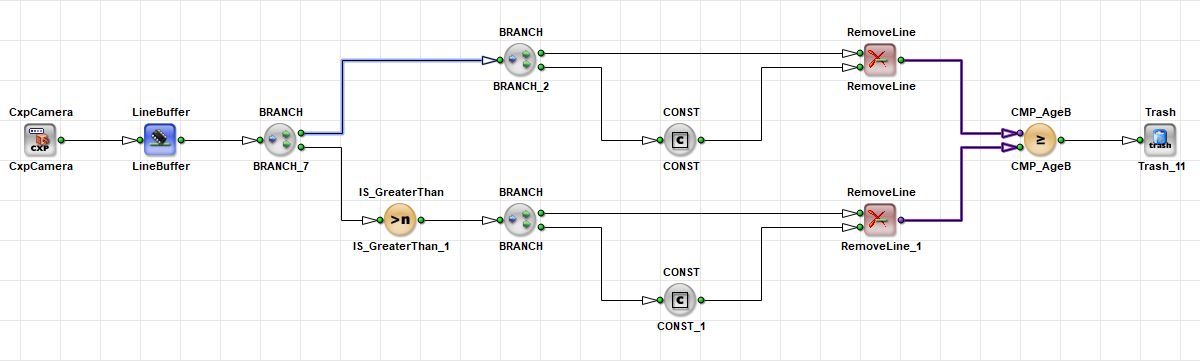
在此處,兩個分支會以不同方式處理同一張影像,然後輸入至一個共用的 CMP operator。由於其中一條路徑上的 M-type operator 使各分支變為非同步,VisualApplets 會回報同步錯誤(紫色連線)——您無法直接將它們連接。這個範例仍然是一台相機,而不是兩個獨立的相機。
透過緩衝區與 SYNC 解決同步錯誤:
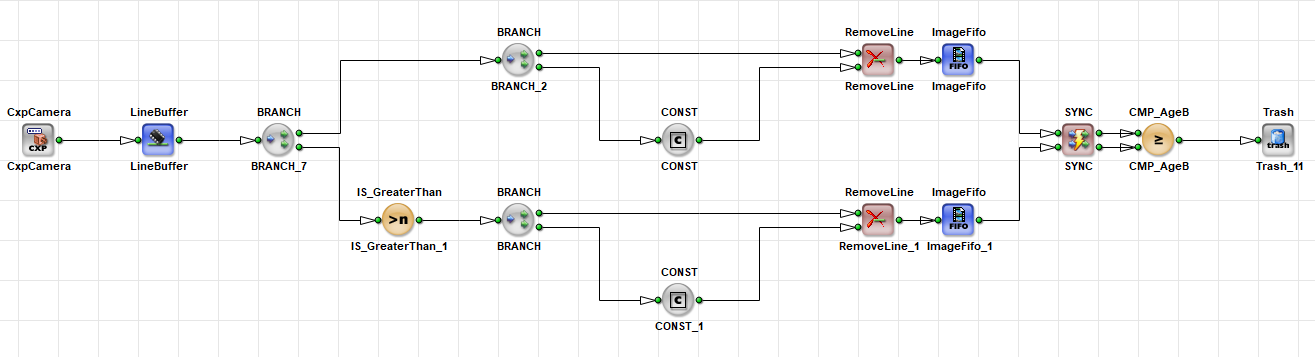
其中一個有效的修正方法是在每個路徑上放置一個 ImageFifo (或其他緩衝區),並使用 SYNC 在 CMP重新同步。這可行,但額外的緩衝區會消耗 FPGA 資源。
透過 MergeKernel 與 SplitKernel 解決同步錯誤:
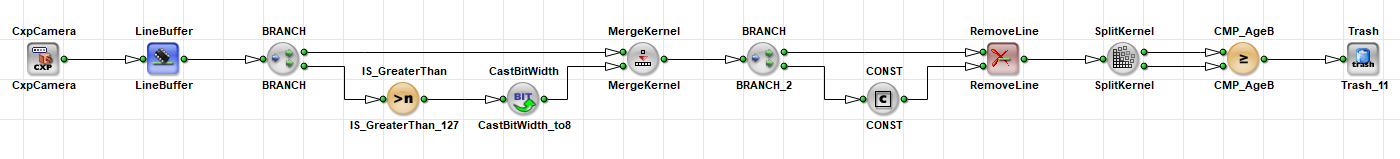
節省資源的替代方案是將這兩種變體作為 kernel 元件傳輸: MergeKernel 將這兩條路徑結合成一個 kernel 連線,處理程序會繼續在該連線上進行,而 SplitKernel 則在 CMP. 否 SYNC 且不需要額外的同步緩衝區。
有關同步與同步錯誤的詳細資訊,請參閱 Operator Types and Synchronization 教學主題。
有關這些算子的詳細資訊,請參閱 Operator Reference 中的 MergeKernel 以及 Operator Reference 中的 SplitKernel。
CastKernel#
CastKernel 會重新組織傳入資料的 Parallelism 與 kernel 大小。您可以在輸出連結上變更 kernel 大小。kernel 列數、kernel 欄數以及 Parallelism 的乘積在輸入端與輸出端必須完全相同。
使用 CastKernel 您可以轉換 parallelism 為核心。例如,具有 1×1 核心的 parallelism 48 會變成具有 48 個核心欄的 parallelism 1。相同的 48 個像素值仍會在一個時脈週期內移動,但它們現在變成了核心元件,而不是平行像素。這對於只允許特定 parallelism 的記憶體算子非常有用。
在 Memory operator 之前將 Parallelism 轉換為 Kernel:
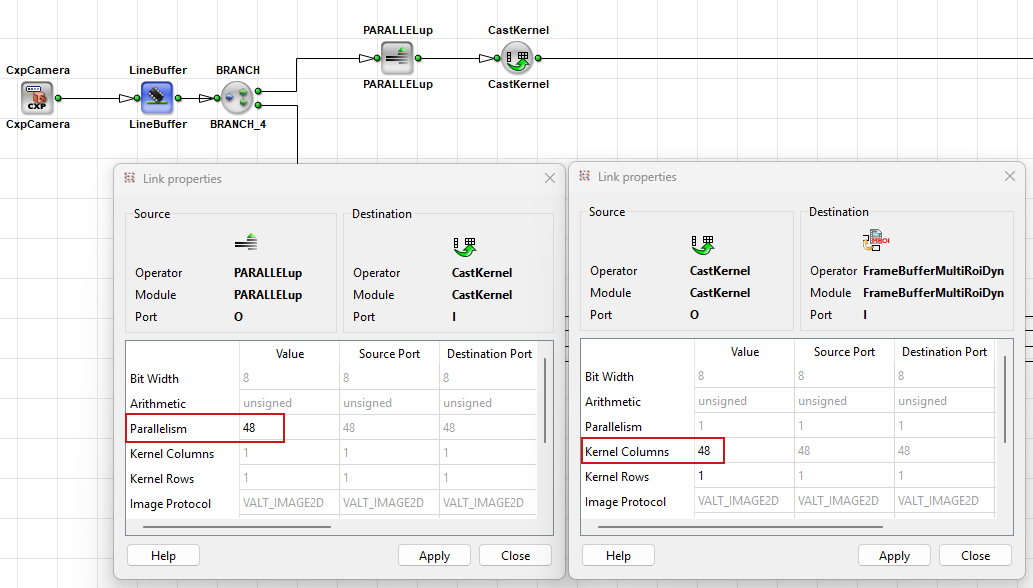
在此螢幕截圖中, PARALLELup 將 Parallelism 提升至 48(1×1 kernel)。 CastKernel 將其重新解釋為具有 48 個 kernel 欄的 Parallelism 1,以便後續的 Memory operator 可以接收該資料。
有關該算子的詳細資訊,請參閱 Operator Reference 中的 CastKernel。
KernelRemap#
KernelRemap 會重新對應輸入與輸出之間的 kernel 元件。kernel 維度保持不變。透過 SourceSelect 參數,您可以將輸入 kernel 索引指派給每個輸出 kernel 元件。
透過此 operator,您可以鏡射或旋轉 kernel 內容、將一個輸入元素對應至多個輸出,或捨棄未使用的輸入元素。
使用 KernelRemap 交換 Kernel 欄:
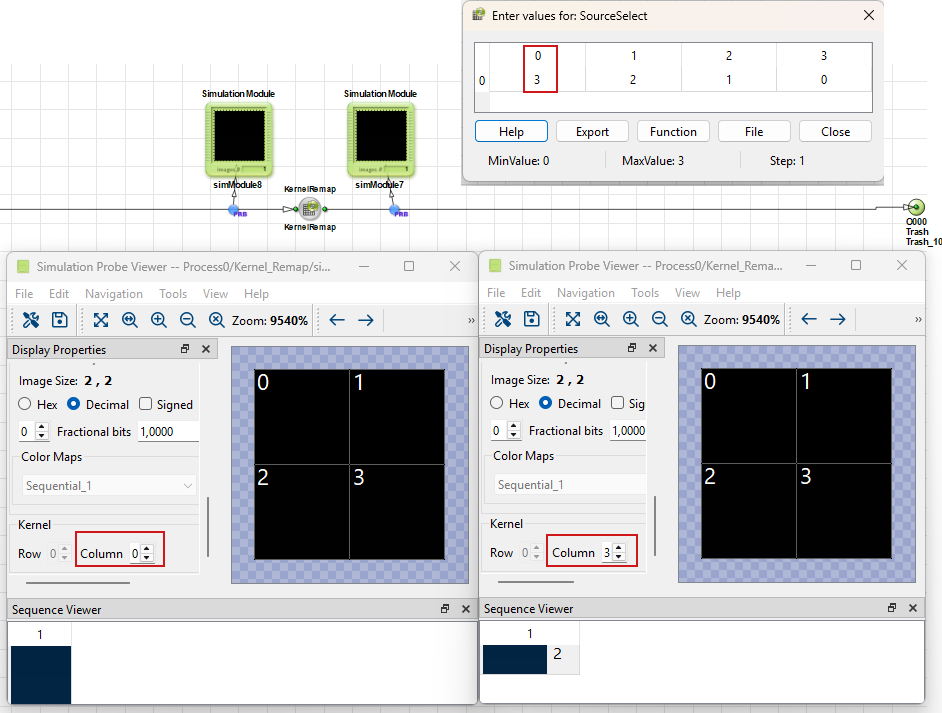
螢幕截圖中的設計顯示了 KernelRemap 如何交換 kernel 欄:第 0 欄與第 3 欄交換位置(內部欄位隨之移動)。對應關係來自於 SourceSelect 參數,此處為 0, 1, 2, 3 → 3, 2, 1, 0。模擬探棒顯示了重新對應之前與之後的 kernel 元件。
有關此算子的詳細資訊,請參閱 Operator Reference 中的 KernelRemap。
連接至 DMA#
原始 kernel link 必須 不會 直接進入 DmaToPC. DmaToPC 僅接受 Kernel Columns = 1 和 Kernel Rows = 1.
因此,請務必在 kernel 輸出與 DmaToPC之間放置以下其中一個 operator。這些 operator 會將 kernel 轉換為單一像素或您可以進一步縮減的較小 kernel:
FIRoperatorNxMSelectSubKernelSplitKernelMIN或MAXMedian
範例設計#
典型的濾波器路徑如下所示:
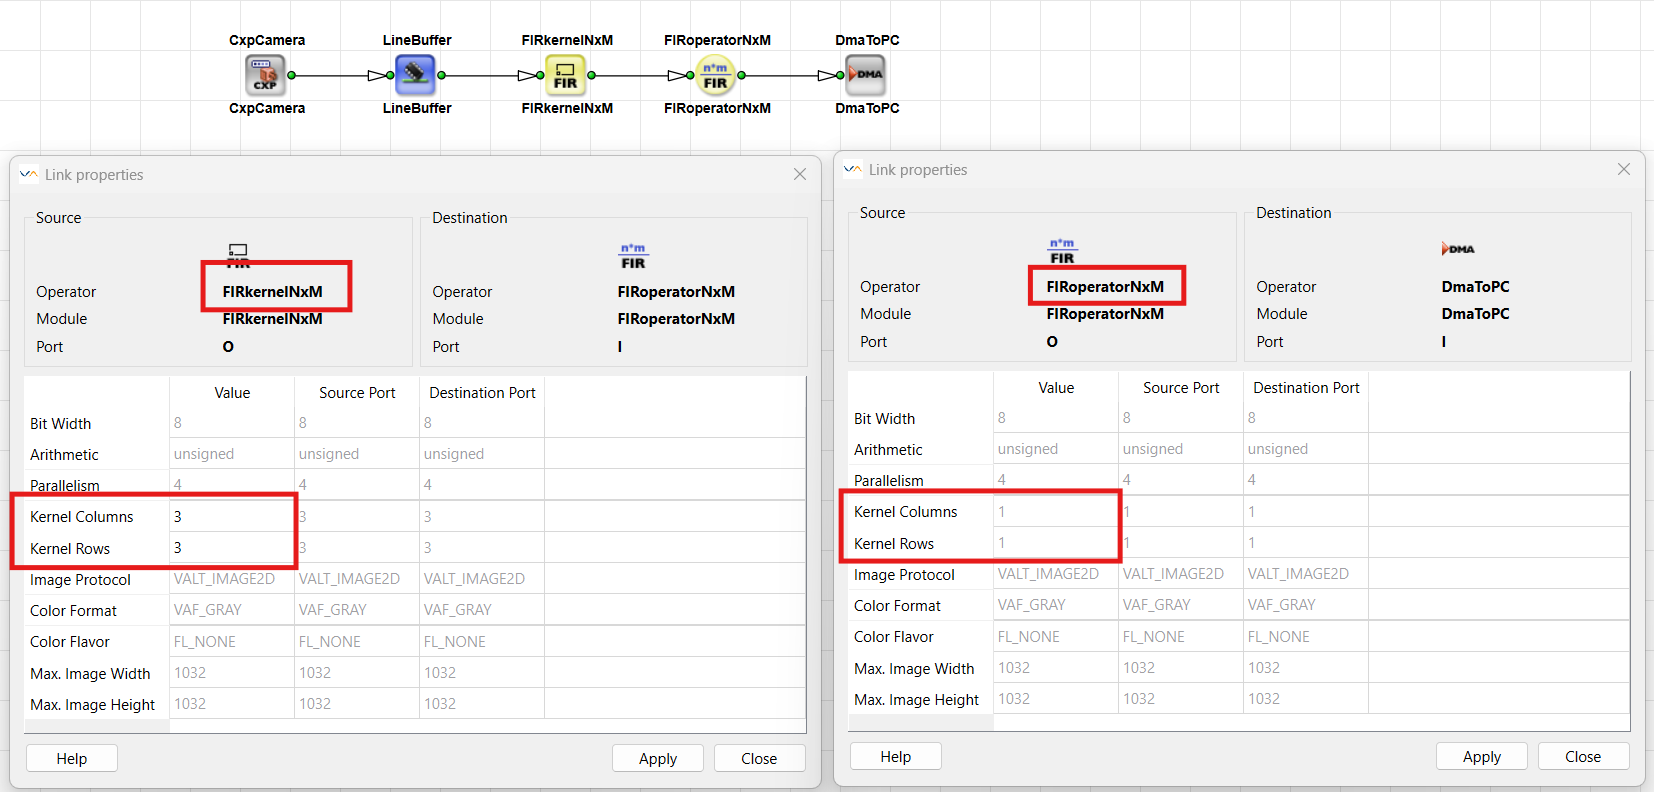
- 相機會輸出單一像素(kernel 1×1)。
- 緩衝區(例如
LineBuffer或ImageBuffer)可將相機與處理程序解耦,並提供相鄰運算子所需的行資料。 FIRkernelNxM會在輸出鏈路上從相鄰像素建構 kernel(例如 3×3 或 5×5)。FIRoperatorNxM會套用濾波器係數並針對每個位置輸出一個像素。DmaToPC會將單像素資料流傳輸至主機。
詳細的濾鏡範例(例如均值、高斯、Sobel、調適型閾值等)列在 Operator Reference 中 FIRkernelNxM 與 FIRoperatorNxM 的 Examples of Use 章節中。
設計準則
務必檢查 支援的 Link 格式 後續算子的內容,然後再於 link 上建立大於 1×1 的 kernel。特別是在執行以下動作之前: DmaToPC之前,請將 kernel 縮減為 1×1。
相關主題#
- 參數化 教學主題 —
KernelColumns和KernelRowslink properties - Parallelism 教學主題 — parallelism 與 kernel 資料速率的比較
- Latency 教學主題 — 緩衝區與濾鏡算子的 latency
- Operator Reference 中的 FIRkernelNxM
- Operator Reference 中的 FIRoperatorNxM
- Operator Reference
- User Manual 中的 Parameterization — 在 GUI 中編輯 link 與 module 參數