延遲#
關鍵術語
延遲 是指單一像素從相機(或其他來源)的輸入,經過生成的 FPGA 管線,直至抵達輸出(例如)所需的時間 DmaToPC. 該延遲發生在幀擷取器上,而非在VisualApplets 編輯器中。 頻寬 是指每秒可透過一條鏈路傳輸的像素數量。
一種設計可以同時具備高頻寬與低延遲:許多像素會並行通過 FPGA 管線,但一幀中的第一個像素在交給 DMA 之前,仍需花費一些時間。
延遲與頻寬#
頻寬與延遲描述了同一條資料管線的不同特性:
| 頻寬 | 延遲 | |
|---|---|---|
| 問題 | 每秒的資料傳輸量是多少? | 一個像素需要等待多久才會被處理? |
| 取決於 | Parallelism 以及基準設計時鐘 | 運算子類型與演算法 |
| 公式(連結) | 頻寬 = 並行度 × 基本設計時脈 | 由各運算子定義;詳見下文 |
管線架構能夠同時傳輸與處理影像資料。例如,當第 1000 個像素已抵達輸出端時,第 5000 個像素可能仍處於相機的輸入端。由於多個像素會並行通過該設計,因此整體資料傳輸速率(頻寬)得以維持在高水準。延遲僅描述單一像素的延遲時間。
設計指引
在由VisualApplets 設計所生成的 FPGA 管線中,延遲時間維持在接近理論最低值的水平。大多數運算元不會儲存完整的影像,而是在資訊一經產生後立即傳遞結果。
延遲的定義#
延遲 是指設計中一個像素的延遲——即從像素進入處理鏈到離開處理鏈(例如,直到它到達 DmaToPC)。
重點:
- 延遲由各營運商自行定義,且主要取決於其演算法的實作方式。
- 新增運算子並不會降低吞吐量。在生成的 FPGA 管線中,所有運算子皆以並行方式運作:當一個模組正在處理一個像素時,其他模組則同時處理其餘的像素。即使管線已填滿,較長的鏈仍可在每個時脈週期接收新的像素(或像素封包)。
- 新增運算子可能會增加 延遲。每個運算子都可能在單一像素的路徑上造成延遲,而這些延遲會沿著鏈路累積。O 型運算子造成的幾個時鐘週期延遲,通常與緩衝區的行延遲或幀延遲相比微不足道。
- 延遲與阻塞或緩衝區填滿程度並不相同。若下游處理速度較慢,緩衝區可能會填滿,導致延遲進一步增加。本主題說明操作子本身內建的最小延遲。
設計範例#
本主題全程採用以下設計。該設計展示了一個包含一個緩衝區和兩個處理步驟的簡單資料擷取路徑:
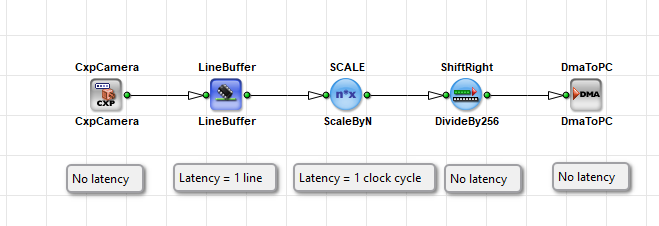
上述設計中的延遲註解適用於此特定範例:
| 運算子 | 此範例中的延遲 |
|---|---|
CxpCamera | 在此範例中,不會產生額外的演算法延遲 |
LineBuffer | 1 行 |
ScaleByN | 1 個時脈週期 |
ShiftRight | 無額外延遲 |
DmaToPC | 在此範例中,不會產生額外的演算法延遲 |
此路徑上單一像素的總延遲主要取決於 一行延遲 的項 LineBuffer,再加上其他運算子的微小處理延遲。對於 CxpCamera 進行明確的生命週期管理即呼叫 DmaToPC 這表示在這個範例中,這些運算子不會造成此類額外的延遲。這並不表示像素會立即顯示在電腦上。相機介面的時序、PCIe 傳輸、主機緩衝區以及顯示過程均不包含在此表中。
範例設計中的像素流#
在範例設計中,像素會從相機透過相機介面傳輸至 LineBuffer. 該 LineBuffer 在將資料轉發至輸出端之前,會先收集完整的一行資料。
當整行資料儲存至 LineBuffer, 緩衝區會輸出該行中的像素。在 同一時間,相機已經將 下一行. 這是所產生 FPGA 硬體的管線化運作方式:擷取、緩衝、處理及 DMA 作業可重疊進行。VisualApplets 描述了該管線;該程式並不會直接處理攝影機的影像串流。
延遲的計算#
延遲取決於運算單元。整個設計並無單一的延遲數值。您需將單一像素路徑上的各項延遲相加(或依時間順序累加)。
基於行(Line)的延遲(緩衝區運算子)#
諸如以下這類緩衝區運算子: ImageBuffer 進行明確的生命週期管理即呼叫 LineBuffer 至少需要 一行完整內容 在輸出該行第一個像素之前。對於 LineBuffer 在上述範例中:
延遲 = 1 行
以時間為單位測量時,一條線路的延遲為:
行延遲 = (每行像素數) / (鏈路的像素傳輸速率)
像素傳輸速率取決於並行度與基礎設計時鐘。傳輸線越寬或通訊鏈路速度越慢,第一個像素離開緩衝區所需的時間就越長。
時脈週期延遲(處理運算子)#
許多處理運算器會將一個像素延遲固定數個時鐘週期。當管線填滿後,它們仍能在每個時鐘週期接受並輸出一個像素(或一個並行像素封包)。此時,單一像素的延遲僅取決於這些內部寄存器級。
在範例設計中, ScaleByN 補充道:
延遲 = 1 個時脈週期
以時間為單位計算,一個時鐘週期的延遲為:
週期延遲 = 1 / 基本設計時脈頻率
舉例來說,當基本設計時脈為 312.5 MHz 時,一個時脈週期為 3.2 ns。
運算子,例如 ShiftRight 在此範例中,請加入 沒有顯著的延遲 在實際應用中,它們會在輸入值一經取得後立即傳遞結果。
運算子類型與延遲#
VisualApplets 將運算子分組為各類型。類型有助於估算延遲:
| Type | 圖示形狀 | 典型的延遲行為 |
|---|---|---|
| O型 | 圓形 | 非常小的固定延遲——通常為固定數量的時脈週期。例如:約3.2 ns的延遲(在 312.5 MHz 基本設計時脈下為一個週期)。 |
| M型 | 正方形 | 可變延遲。可對行或幀進行緩衝、變更影像尺寸,或阻斷輸入。有關確切的延遲時間,請參閱操作手冊。 |
| P型 | 正方形 | 與 M 型類似,但不會主動阻斷輸入。請參閱操作手冊以確認確切的延遲時間。 |
CxpCamera, LineBuffer以及 DmaToPC 是 M 型算子。 ScaleByN 進行明確的生命週期管理即呼叫 ShiftRight 是 O 型運算子。儘管 DmaToPC 由於它是 M 型,因此在該範例中並不會造成顯著的演算法延遲——資料一經傳入,便會立即交由 DMA 處理。至於影像何時能在主機軟體中顯示出來,則是另一個稍後才會發生的延遲。
關鍵術語
請將 O 型運算子視為固定長度的短管段;將 M 型運算子視為可能包含儲存槽(緩衝器)或更複雜機械裝置的管段。儲存槽必須先填滿,第一滴液體才會流出——這就是基於管線的延遲。這些管線和儲存槽是 FPGA 上的硬體階段,由您在VisualApplets 中放置的模組所產生。
Parallelism 以及延遲#
Parallelism 這並不會消除延遲。它會增加頻寬:每時鐘週期透過鏈路的像素數量會增加。
範例:當並行度為 4 時,一個時鐘週期內會有四個像素通過一個連結。該 第一個像素 一個幀仍需相同的運算延遲,例如,在 ImageBuffer. 當管線填滿後,每個時鐘週期可有四個新的像素離開運算器。
- 高並行度→ 高吞吐量(頻寬)。
- 緩衝區與演算法→ 第一個像素的延遲。
這兩項特性是相互獨立的。VisualApplets 的設計旨在使生成的 FPGA 管線具備高頻寬與最低延遲。
計算運算子的延遲值#
若要查找您在設計中欲使用的運算子的延遲值,請參考以下來源:
- 運算子參考— 每個運算子都會在「運算子參考」中記載其延遲(或處理延遲)。
- 產品內建說明— 在設計中選取運算子,即可開啟說明以查看參數與時序的詳細資訊。此內容與《運算子參考》相同,並以工具內建說明的形式提供於VisualApplets 中。
特別是對於 M 型運算子,請務必查閱相關文件。延遲可能取決於特定參數(例如,濾波運算子中的核心大小,或記憶體運算子中的緩衝區深度)。
大多數運算子並不會儲存完整的影像。它們會在資訊一經取得且輸出未受阻滯時,立即計算出輸出結果。正因如此,所建立的 FPGA 管線中的延遲,才能維持在所選演算法的理論最低值附近。
如果輸出遭到阻塞(例如因為電腦無法以足夠快的速度接收資料),緩衝區的填滿程度就會增加,而像素出現在主機所需的時間也會隨之延長。這種額外的延遲並非固定的運算員延遲——它源自於負載下的流量控制與緩衝機制。
相關主題#
- 「管線概念」教學主題 — 無緩衝流量與並行處理
- Parallelism 教學主題 — 並行處理與延遲
- 運算子類型與同步教學主題 — 運算子類型與延遲
- 《記憶體元件教學》主題 — 緩衝運算子的行延遲
- 《核心操作教學》主題 — 與核心相關的延遲
- 使用手冊中關於 Applet 的頻寬— 頻寬與延遲的比較
- 運算子參考— 各運算子的延遲值
- 裝置資源— 基本設計時脈頻率