Memory 元素#
本主題說明在VisualApplets 設計中,記憶體運算子如何映射至目標硬體上的實體記憶體,以及何時該使用哪種類型。閱讀完本主題後,您將了解FPGA 內部記憶體(例如區塊 RAM)與幀擷取器 DRAM 之間的差異、FIFO 式緩衝區與隨機存取幀緩衝區的區別、共用 DRAM 頻寬如何限制包含多個 RAM 運算子的設計,以及如何在模擬和硬體環境中辨識與記憶體相關的問題。
關鍵術語
FillLevel可在硬體執行時(例如在microDisplay X 中),告訴您緩衝區的佔用率(以百分比表示)。若緩衝區佔用率長期維持在 100% 附近,通常表示存在瓶頸或死鎖。作為起點,請在攝影機後方放置一個緩衝區。
有關平台 RAM 容量、資料位寬及頻寬的數值,請參閱「裝置資源」。
FPGA 記憶體與幀擷取卡 DRAM 的比較#
VisualApplets 記憶體運算子可根據其在幀擷取卡上儲存資料的位置分為兩類。第二項區別在於其存取資料的方式:FIFO 式緩衝區與隨機存取或多 ROI 幀緩衝區。在《運算子參考手冊》中的「Memory Library 概覽」中,說明了每個記憶體運算子儲存資料的位置。VisualApplets 中的 RAM資源是一個裝置資源標記,其對應於板載 DRAM。它並非VisualApplets 應用程式內的記憶體。
| Property | FPGA 內部記憶體 | 幀擷取卡 DRAM |
|---|---|---|
| 常見的運算子 | ImageFifo;對於小型隨機存取的情況亦然 FrameMemoryRandomRd / LineMemoryRandomRd | ImageBuffer, LineBuffer, FrameBufferRandomRead, FrameBufferMultiRoi, FrameBufferMultiRoiDyn |
| 地點 | FPGA 內部結構(BRAM、LUT RAM 或 URAM,詳見imaFlex CXP-12 Quad/Penta ) | 在電路板上,位於 FPGA 外部 |
| 容量 | 有限;全解析度的幀往往會超出 FPGA 的可用記憶體容量 | 較高;適用於多行或全頁格式 |
| 延遲 | 低;無法存取外部 DRAM 匯流排 | 行導向的 FIFO 會至少新增一行 |
| VisualApplets RAM 資源 | 否 — 不會預留 RAM 裝置資源 | 是的——每個執行個體對應一個 RAM 資源,並映射至板載 DRAM |
| 頻寬 | 本地;操作系統不會爭取幀擷取卡的 RAM 介面 | 在同一物理介面上由 RAM 運算者共用 — 請參閱「DRAM 頻寬共享」 |
請參閱「選擇記憶體運算子」中的表格來選擇一個運算子,然後閱讀對應運算子的章節,以了解參數及平台相關細節。
選擇記憶體運算子#
| 用例 | 偏好 |
|---|---|
| 緩衝區小、延遲低、不佔用 DRAM 頻寬 | ImageFifo (FPGA 內部) |
| mE5 上的 FIFO 影像、峰值吸收、ROI | ImageBuffer (DRAM) |
| 啟用 FIFO 排程imaFlex CXP-12 Quad/Penta | LineBuffer (DRAM) |
緩衝區之前 SYNC 稍有延遲 | ImageFifo (若延遲較大,則使用更大的 DRAM 緩衝區) |
| 具備隨機像素讀取功能的全畫幅儲存裝置 | FrameBufferRandomRead (DRAM) |
| 從一個緩衝區建立多個或動態的感興趣區域 (ROI) | FrameBufferMultiRoi / FrameBufferMultiRoiDyn (DRAM) |
設計指引
Basler 建議您在設計中至少使用一個 DRAM 運算單元,以補償來自攝影機的資料突發。該 DRAM 緩衝區即是攝影機的預設去耦路徑(LineBuffer 或 ImageBuffer)。 ImageFifo 當您需要緩衝相機的連拍時,它無法取代那個 DRAM 緩衝區。
ImageFifo#
當 ImageFifo 運算子將影像資料排入佇列作為一個 先入先出 FPGA 內部記憶體中的緩衝區。您可以透過 EntitiesToStore 進行明確的生命週期管理即呼叫 EntityType 參數。 EntityType 具有以下數值 PIXEL, LINE,或 FRAME. 當輸出端空閒時,資料會立即被轉發。當下游模組阻塞時,緩衝區便會填滿。
將相機中的 InfiniteSource 參數(屬於 ImageFifo 運算子至 ENABLED 當輸入來自無法停止的來源(例如攝影機)時。
資訊
當 ImageFifo 運算子僅能緩衝相對少量的像素。因此,存在顯著的 FIFO 溢出風險,而運算子並非總能在內部以穩健的方式處理此問題。對於不可中斷的資料流,Basler 建議將 ImageFifo 前接一個 Overflow 運算子,或使用 ImageFlowControl 運算子,而不是 ImageFifo operator 來完成。的 ImageFlowControl 此運算子結合了 FIFO 緩衝與整合式溢出處理功能。
使用該參數 ImplementationType 您可以選擇 AUTO (預設), BRAM, LUTRAM,或 — 在imaFlex CXP-12 Quad/Penta — URAM. Basler 建議始終使用 AUTO 除非某種特定的 FPGA 資源類型出現短缺。
有關此運算子的詳細資訊,請參閱《運算子參考指南》中的「ImageFifo」。
ImageBuffer 與 LineBuffer#
當 ImageBuffer (microEnable 5) 以及 LineBuffer (imaFlex) 運算子的工作原理類似於一個 行導向 FIFO: 選取的 ROI 中的已完成行,將在下游模組能夠接收時立即轉發。延遲至少為 一行. 若緩衝區填滿,由於輸出被阻塞,延遲便會增加。另請參閱 延遲 教學主題。
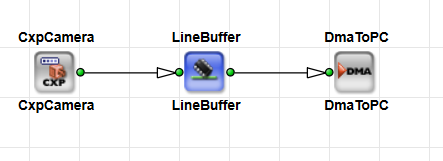
平台說明:ImageBuffer 與 LineBuffer 的比較#
| 運算子 | 平台 |
|---|---|
ImageBuffer | microEnable 5 (mE5) |
LineBuffer | imaFlex CXP-12 四埠/五埠 |
imaFlex CXP-12 四埠與五埠版本 不支持 該 ImageBuffer 運算子。當您將設計從 mE5 轉換為 imaFlex 時,VisualApplets 取代 每個 ImageBuffer 帶有 a 的運算子 LineBuffer operator 來完成。的 LineBuffer 該操作員為 imaFlex 平台提供了相同的核心緩衝與 ROI 功能。
使用 ImageBuffer 和 LineBuffer 定義感興趣區域 (ROI)#
隨著 ImageBuffer 進行明確的生命週期管理即呼叫 LineBuffer 操作員,您也可以定義感興趣區域 (ROIs)。方法是設定 XOffset, XLength, YOffset以及 YLength parameters. Edge cases are documented in the Operator Reference: For example, if the input is smaller than the requested ROI, or if your design is in Line1D 模式,或者若額外像素的內容未定義。
有關此運算子的詳細資訊,請參閱《運算子參考手冊》中的「LineBuffer」及「ImageBuffer」。
監控緩衝區的使用狀況與溢出#
當 ImageBuffer 進行明確的生命週期管理即呼叫 LineBuffer 運算子提供以下狀態參數,用以監控緩衝區的使用狀況與溢出:
| 參數 | 含意 |
|---|---|
FillLevel | 以百分比表示緩衝 RAM 的佔用程度(在 ImageBuffer (以 25% 為增量)。 |
LineCount | 顯示目前儲存的行數。僅適用於 LineBuffer 運算子。 |
Overflow | 表示緩衝區若再接收更多資料,將超過容量上限。此狀態參數與 Overflow 同步函式庫中的運算子,與算術溢出不同。請參閱 可停止與不可停止的資料串流 教學主題與 位元 Arithmetic 教學主題。 |
若發生溢出,傳入的資料可能會被捨棄,且有效影像高度可能會減少。不完整的影像可能會留在記憶體中,直到操作員恢復為止。 Overflow 當來源無法停止時適用,且 InfiniteSource 是 ENABLED. 設定 InfiniteSource 設為 ENABLED 當緩衝區緊接在攝影機或其他無限光源之後時。另請參閱 可停止與不可停止的資料串流 教學主題。有關在除錯時如何使用這些參數,請參閱 辨識與記憶相關的錯誤.
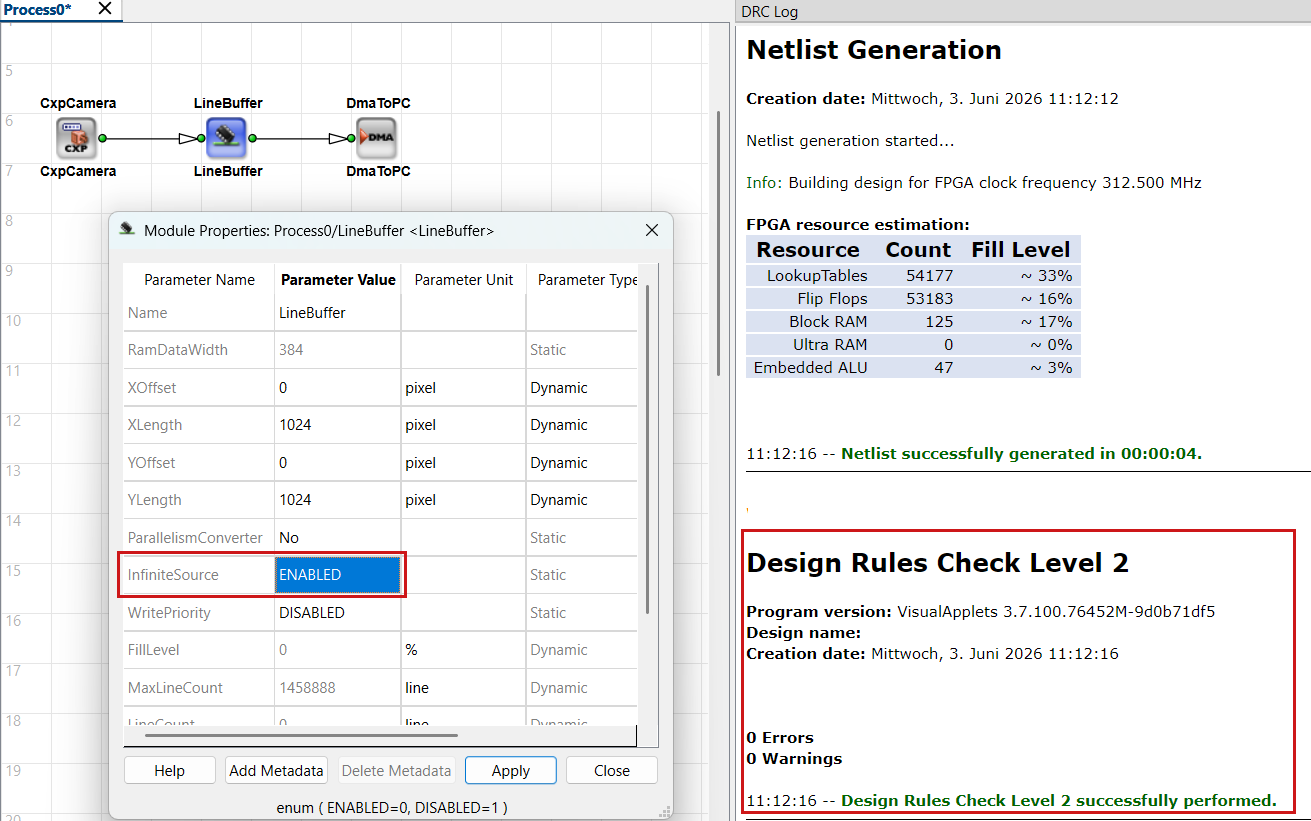
在 LineBuffer 操作員,Basler 建議啟用 WritePriority 當參數為 InfiniteSource 是 ENABLED。如果 WritePriority 是 ENABLED, 當暫時寫入速率超過可用 DRAM 頻寬時,相較於讀取操作,應優先進行相機的批次寫入操作。該 平均 頻寬仍須維持在該營運商可用的配額範圍內。
當 LineBuffer 該運算子亦可透過模組參數轉換輸入與輸出之間的並行性 ParallelismConverter, 因此您未必總是需要一個獨立的 PARALLELup / PARALLELdn. 另請參閱 Parallelism 教學主題。
使用 FrameBuffer 運算子實現全幀、隨機存取及多 ROI#
當 FrameBufferRandomRead, FrameBufferMultiRoi以及 FrameBufferMultiRoiDyn 營運商商店 完整影像或大範圍區域 並按照以下順序閱讀它們: 不是 嚴格的 FIFO 線。當您需要隨機存取像素,或從單一緩衝區取得多個感興趣區域 (ROI) 時,請使用此功能。
FrameBufferRandomRead#
FrameBufferRandomRead 將輸入影像寫入 DRAM,然後透過以下方式讀取像素: 欄位與列位址 在專用位址連接埠上。可用於幾何變換、重新映射及其他隨機存取模式。
對於小型幀或線,建議優先使用 FPGA 內建運算子,例如 FrameMemoryRandomRd 或 LineMemoryRandomRd 而非 DRAM 營運商。
有關此運算子的詳細資訊,請參閱《運算子參考手冊》中的「FrameBufferRandomRead」。
FrameBufferMultiRoi 以及 FrameBufferMultiRoiDyn#
當 FrameBufferMultiRoi 進行明確的生命週期管理即呼叫 FrameBufferMultiRoiDyn 運算子用於儲存影像資料並進行輸出 多個感興趣區域. FrameBufferMultiRoiDyn 允許 動態 從控制鏈路獲取 ROI 的大小與位置。
DRAM 頻寬的共享#
每個 DRAM 操作者都需要一個類型為RAM 的「VisualApplets 」資源。該資源在「VisualApplets 」資源模型中屬於一個插槽,並對應至幀擷取卡上的實體 DRAM。在 imaFlex 和 microEnable 5marathon 平台上,所有預留RAM資源的操作者皆共用同一組實體 DRAM。每個操作者會獲得一個專屬且不重疊的記憶體 區塊,但其大小與頻寬將分配給同一實體介面上所有處於活動狀態的 RAM 操作者。
後果:
- 每次讀取和每次寫入都會消耗共用介面的頻寬。
- 當存在多個 DRAM 實例或高吞吐量時,總流量可能會超過平台限制。
- 需求過剩導致堵塞,並引發價格上漲
FillLevel、溢出,或可維持的幀率降低。
請在「裝置資源」中查詢您所使用平台的RAM 容量、RAM 資料位寬以及 RAM 總頻寬(共用)。
請在需要時於「資源」對話方塊中分配資源;請參閱「裝置資源」中的「裝置資源分配」。
頻寬計算注意事項#
《共享記憶體應用說明》闡述了如何有效運用 RAM 容量與 RAM 資料位寬。
重點:
-
讀取與寫入共用同一介面。對於單一 DRAM 操作者,在估算可用影像資料傳輸速率時,請將平台最大頻寬除以2(寫入佔一半,讀取佔一半),然後套用效率係數。文件中記載的頻寬值為理論最大值;實際效率會較低。
-
請盡可能多地利用 RAM 資料寬度。該鏈路的有效 RAM 資料寬度為:
位元寬度 × 並行度 × 核心元素數
該數值即為每次 DRAM 存取的有效位寬。請勿將其與「並行度 × 基本設計時脈」所計算出的像素速率頻寬混淆。當該數值等於平台RAM 資料位寬且未超過其上限時,即可達到 DRAM 的最大吞吐量;例如 256 位元、384 位元或 640 位元,具體取決於電路板規格。 將該數值與最大 RAM 資料寬度相匹配,可充分利用 DRAM 的寫入與讀取頻寬;若該數值遠低於此,DRAM 存取便可能成為瓶頸。以 8 位元 × 並行度 4 的設計為例,在 256 位元的介面中僅使用 32 位元,便會浪費頻寬的餘裕空間。
-
多個 DRAM 操作者共享頻寬。在共享記憶體平台上,單一操作者可用的頻寬大致與該介面上的RAM 操作者數量成反比(即1 / (RAM 操作者數量))。詳細資訊因平台而異,相關說明請參閱《裝置資源》及《應用說明:共享記憶體》(請參閱「相關主題」)。
-
當平台提供多個實體介面時(例如imaFlex 2 Dual 100 ),請將運算子分散配置於不同的獨立 RAM 銀行中。頻寬僅限於同一實體銀行內的運算子之間共享。
設計指引
請及早規劃 RAM 使用量。每增加一個 DRAM 運算子,都會減少同一物理記憶體介面上其他運算子可用的頻寬。在新增另一個 DRAM 緩衝區之前,請先計算總讀寫流量,並將其與平台可用的共享頻寬進行比較(請參閱「裝置資源」)。建議 ImageFifo (FPGA 記憶體) 用於小型去耦任務,以免不必要地消耗 DRAM 頻寬。
辨識與記憶相關的錯誤#
VisualApplets 無法總是驗證某個設計是否具備足夠且類型與大小皆符合需求的記憶體,以因應每種執行時情境。您必須選擇與影像尺寸、幀率及同步需求相符的運算子與緩衝區大小。
即使緩衝區大小不足以滿足硬體需求,模擬仍可能成功執行。錯誤通常只會出現在幀擷取卡上:例如,儘管模擬看起來一切正常,但 SDK 中卻未輸出任何影像。
常見的原因包括 SYNC 死鎖 進行明確的生命週期管理即呼叫 記憶體不足或錯誤.
為避免這些問題,請進行以下檢查:
- 在完成緩衝器與 DMA 路徑的佈線後,執行第 1 級和第 2 級設計規則檢查。
- 關於硬體,請留意
FillLevel(以及Overflow(如有提供),例如在microDisplay X 中。持續顯示 100% 佔用率通常表示發生死鎖或頻寬瓶頸。 - 若有多個 DRAM 操作者,請開啟「設計→裝置資源」,並驗證 RAM 分配及預期的頻寬佔用比例。
- 對於無限源,請確認
InfiniteSource是ENABLED在每個接受不可中斷資料流的緩衝區上。
典型的管線範例#
透過 DRAM 線路緩衝器將影像從攝影機傳輸至 DMA#
最簡化的設計包含一名攝影師,以及一個 DRAM 緩衝區,其中 InfiniteSource 設定為 ENABLED,以及一個 DmaToPC 運算子:
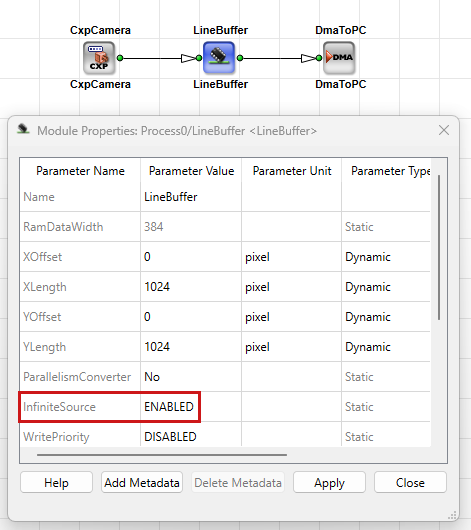
使用此緩衝區來吸收峰值,並將資料饋送至基線處理。請注意 FillLevel 在硬體層面上;若該數值長期維持在 100% 附近,通常表示存在瓶頸或死鎖。請參閱 辨識與記憶相關的錯誤.
透過 LineBuffer 將相機影像傳入 3×3 核心#
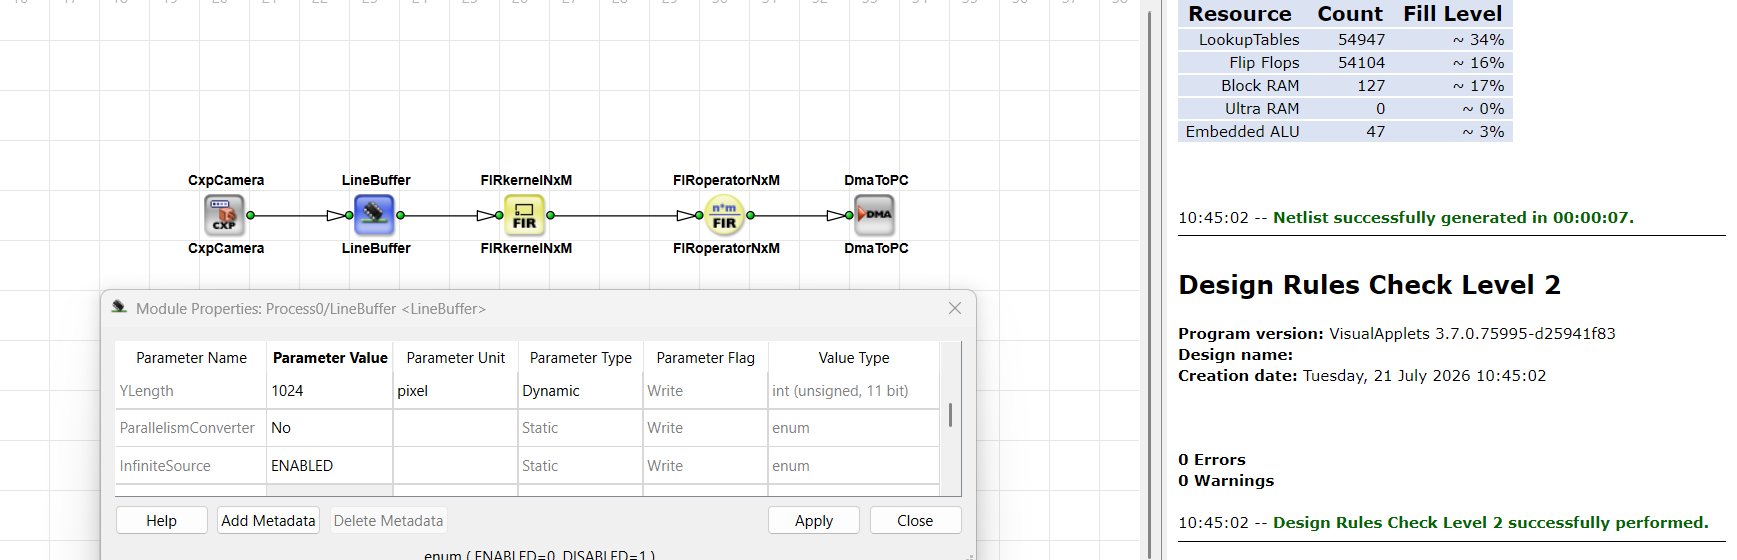
在以下設計中,DRAM 緩衝器為鄰域運算子提供資料線,該運算子用於建構濾波器核心(例如 3×3)。該緩衝器會增加至少一行的延遲——若因濾波器路徑阻塞而導致緩衝器填滿,延遲將進一步增加。請考量共享 DRAM 頻寬的 LineBuffer 運算子也是如此。如螢幕截圖所示的「設計規則檢查」功能,會在您進行編譯之前,確認連結格式與緩衝區設定是否一致。
相關主題#
- 可停止與不可停止的資料串流 教學主題 —
InfiniteSource, 溢出, 相機解耦 - Parallelism 教學主題 — 頻寬、RAM 資料位寬、
LineBuffer並行處理轉換 - 延遲教學主題— 緩衝運算子的線路延遲
- Operator 類型與同步 教學主題 — 先前討論過的緩衝區
SYNC - 裝置資源— 平台 RAM 與共用記憶體的概念
- 共享記憶體應用說明 — 高效利用 DRAM 及頻寬範例
- Memory Library 在《運算子參考》中 — 按記憶體類型分類的運算子概覽