pylon AI 入門#
若要使用 pylon AI,您必須安裝下列元件:
- pylon Software Suite
- pylon Supplementary Package for pylon AI
本主題將說明該補充套件的安裝方式。 - 您也需要所要使用的 vTools 授權。如需如何取得與啟用這些授權的資訊,請參閱 vTool Licensing 主題。
pylon Supplementary Package for pylon AI 提供可讓 AI vTools 執行深度學習模型的後端服務。此後端服務為搭配 Basler 附加元件的 NVIDIA Triton Inference Server,支援模型加密與授權。
這是 Triton Inference Server 在開發環境中所處位置的概觀:
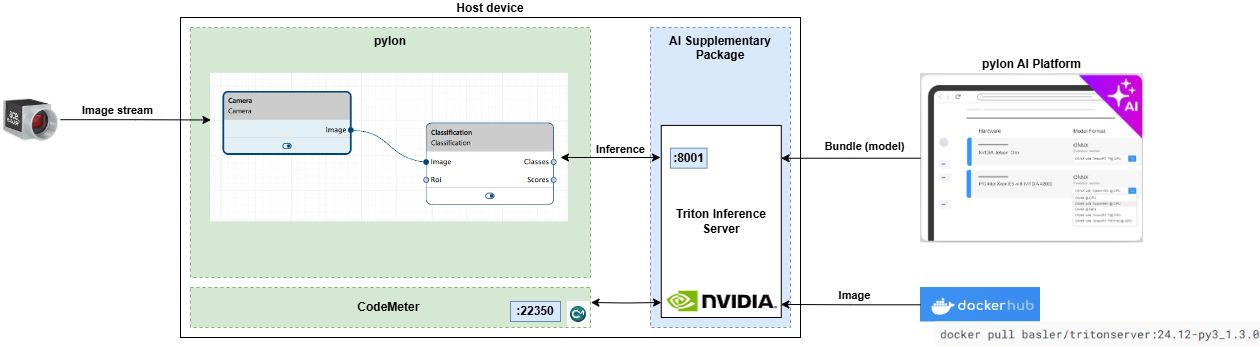
您有兩種安裝 Triton Server 的選項:
- 在本機電腦上
- 在網路中的遠端電腦上
如果您是獨自進行專案,建議使用第一種選項;而第二種選項則較適合團隊協作。
Basler 不提供線上 Triton 伺服器實例,也不建議將伺服器發布為公用網際網路端點。您應始終將其視為開發環境的一部分,並妥善採取保護措施。
pylon Supplementary Package for pylon AI 包含了經過修改的 Docker 映像檔,以便讓 Triton Inference Server 能夠搭配 pylon AI vTools 與 pylon AI Agent 使用。它同時也包含安裝與啟動手稿、版本資訊以及第三方授權條款資訊。
系統需求#
Ubuntu 與 Ubuntu for WSL#
- x86_64 CPU:最新的 Intel Core i5 (或更高階) 或同等級處理器。
- Memory:至少 8 GB 可用 RAM。建議使用 16 GB 或更多的可用 RAM。
- 磁碟類型:建議使用 SSD。
- 磁碟空間:安裝時至少需要 20 GB 的可用磁碟空間。模型儲存庫所需的空間取決於您計劃部署的模型大小和數量。每個模型的容量從幾 megabytes 到幾 gigabytes 不等。
- CUDA 版本:12+
- GPU 卡:適用卡的範例包含 NVIDIA RTX A5000、NVIDIA RTX A2000 Laptop GPU、NVIDIA Tesla T4 等。
資訊
執行 Triton Inference Server 時,CPU 已足夠。若您需要更快的效能,建議使用 GPU。
配備 JetPack 6 的 Jetson Family#
- 模組:所有 NVIDIA Jetson
- Memory:至少 8 GB 可用 RAM。建議使用 16 GB 或更多的可用 RAM。
- 磁碟類型:建議使用 SSD。
- 磁碟空間:安裝時至少需要 20 GB 的可用磁碟空間。模型儲存庫所需的空間取決於您計劃部署的模型大小和數量。每個模型的容量從幾 megabytes 到幾 gigabytes 不等。
先決條件#
資訊
-
安裝過程中需要網際網路連線。
-
請確保本機電腦上的 8000、8001、8002 和 22350 連接埠未遭到封鎖。
由於使用者端可能的情境繁多且複雜,Basler 無法提供通用的解決方案。因此,潛在的存取問題必須由客戶自行處理,並在其 IT 部門的支援下進行。
Ubuntu#
如需詳細資訊,請參閱 install docker on Ubuntu。
如果您的電腦配備 NVIDIA GPU,請參閱 Installing NVIDIA drivers and the NVIDIA Container Toolkit。
Ubuntu for WSL#
資訊
請勿在 WSL 內安裝任何 Linux 顯示驅動程式。驅動程式應直接安裝在 Windows 上。
請遵循這些指示在 Ubuntu OS on WSL 上安裝。
請遵循這些指示在 Docker within Ubuntu on WSL 上安裝。
Jetson Family (JetPack 6.x)#
您的裝置必須使用 SDK Manager 進行燒錄。需要 JetPack 6.x。這已包含 Docker。
所有 OS 變體#
準備好作業系統後,請確保滿足以下要求:
- 已安裝 CodeMeter Runtime。
CodeMeter Runtime 的安裝是 pylon Software Suite 安裝的一部分。 - 適用於 AI vTools 的授權可用。
如需詳細資訊,請造訪 Basler 網站。 -
已安裝 Docker Engine。
若要檢查是否已安裝 Docker Engine: -
針對 GPU 使用:已安裝 NVIDIA Container Toolkit。
若要檢查是否已安裝此工具組:如果尚未安裝,請閱讀以下章節。
安裝 NVIDIA 驅動程式與 NVIDIA Container Toolkit(GPU 使用所需)#
NVIDIA Container Toolkit 提供了 GPU 加速運算所需的程式庫和工具。Triton Inference Server 使用 CUDA 來執行 GPU 加速運算,例如模型推論。NVIDIA Container Toolkit 的版本應與 Triton Server 及您所部署模型所期望的版本相符。
若要檢查 NVIDIA 驅動程式的版本,請開啟終端機並輸入以下指令:
如果尚未安裝任何驅動程式或工具組,請遵循此頁面上的指示:https://docs.nvidia.com/datacenter/cloud-native/container-toolkit/latest/install-guide.html
請查看此頁面以確保您的 NVIDIA 驅動程式與 NVIDIA Container Toolkit 及 Triton Inference Server 相容:https://docs.nvidia.com/deeplearning/triton-inference-server/release-notes/rel-24-11.html#rel-24-11
安裝 Triton Inference Server#
模型儲存庫會在安裝過程中建立於您的家目錄中,例如 /home/username/pylon_ai/model_repository。您切勿變更它。
線上安裝#
若要從 pylon Supplementary Package for pylon AI 安裝 Triton Inference Server,請遵循下列步驟:
- 切換至包含您從 Basler 網站下載之 pylon-supplementary-package-for-pylon-ai-*.tar.gz 封存檔的目錄。
-
將 pylon AI 的 pylon 補充套件 tar.gz 封存檔解壓縮至您選擇的目錄(若要解壓縮至其他目錄,請替換 ./pylon_ai_setup)。
-
切換至您解壓縮 pylon AI 的 pylon 補充套件所在的資料夾。
-
以 root 權限執行安裝指令碼。
離線安裝#
在無法連線網際網路的情況下,請遵循以下步驟。
- 在可連線網際網路的電腦上,造訪 dockerhub 並下載 Basler Triton Server Docker 映像檔。
該映像檔可透過以下連結取得:https://hub.docker.com/repository/docker/basler/tritonserver/general -
將映像檔傳輸至您要安裝 Triton Server 的電腦上。
您可以使用下列指令來執行步驟 1 和 2。範例:
-
切換至包含您從 Basler 網站下載之 pylon-supplementary-package-for-pylon-ai-*.tar.gz 封存檔的目錄。
-
將 pylon AI 的 pylon 補充套件 tar.gz 封存檔解壓縮至您選擇的目錄(若要解壓縮至其他目錄,請替換 ./pylon_ai_setup)。
-
將儲存的 .tar 檔案複製到 pylon_ai_setup 資料夾中。
-
以 root 權限執行安裝指令碼。
啟動 Triton Inference Server#
本節詳細介紹啟動 Inference Server 的三種不同方法。請考量以下關於遠端執行伺服器與 vTools 的資訊,選擇最符合您需求的辦法。
當您啟動 Inference Server 時,伺服器會預期模型儲存庫位於預設位置,即 /home/username/pylon_ai/model_repository。如果您不小心重新命名或刪除該儲存庫,必須透過重新安裝伺服器來重新建立它。
遠端執行伺服器與 vTools
如果您在遠端電腦上執行 Triton Inference Server,同時又從其他位置執行 AI vTools 或 AI Agent,請注意以下重要限制與注意事項:
- 發出推論要求的 vTools 與 Triton Inference Server 之間傳輸資料所需的時間,可能會影響整體回應時間。
- 高延遲會減慢推論過程,特別是對於即時應用程式而言。
- 有限的網路頻寬可能會導致通訊緩慢或不可靠,在傳輸大量資料時尤其明顯。
- 遠端功能需要連接埠 8000、8001 和 8002 能夠存取。(這可能需要 IT 部門的支援,例如執行防火牆和代理伺服器檢查。)
在需要時啟動伺服器#
如果您不想在電腦啟動時將 Triton Inference Server 當作 Docker 容器啟動,您可以在需要時使用下列 Shell 指令碼來啟動 Triton Inference Server。
- 切換至您解壓縮 pylon AI 的 pylon 補充套件所在的資料夾。
-
啟動 Triton Inference Server。
在開機時啟動伺服器#
若要在開機時自動啟動 Triton Inference Server Docker 容器,或在發生當機時自動重新啟動,您可以透過執行帶有額外參數的 "run-pylon-ai-triton-inference-server.sh" Shell 指令碼,建立符合您需求的 systemd 服務。
- 切換至您解壓縮 pylon AI 的 pylon 補充套件所在的資料夾。
-
啟動安裝程式指令碼。
將 Triton Inference Server 安裝為服務之後,您可以在需要時暫時將其停止。請記住,在重新開機您的裝置後,它將會自動啟動。
若要暫時停止負責執行 Triton Inference Server 的 systemd 服務,請開啟終端機(在任何目錄中)並執行:
如果您想恢復該服務,必須透過執行以下指令來啟動它:
如果您在使用服務所管理的目前執行中伺服器時遇到問題,可以透過執行以下指令來重新啟動它:
如果您想要永久停用該服務,可以透過執行以下指令來達成:
授權#
您可以在這裡或 pylon AI 的 pylon 補充套件所包含的授權檔案中找到授權資訊。
故障排除#
CodeMeter 會在 pylon 安裝期間進行設定,以便 Triton Inference Server 能夠存取所需的授權。
在罕見的情況下,這可能會失敗。如果發生這種情況,請將 CodeMeter 設定為網路伺服器:
- 開啟 CodeMeter Control Center,然後點擊右下角的 WebAdmin 按鈕。
- 在 CodeMeter WebAdmin 中,導航至 Configuration > Server > Server Access。
- 在 Network Server 區域中,選擇 Enable 並點擊 Apply 確認。
- 返回 CodeMeter Control Center。
- 在 Process 選單中,按一下 Restart CodeMeter Service 以將 CodeMeter 重新啟動為網路伺服器。
已知問題#
Jetson Orin 上的 ONNX Runtime 錯誤
當在 Jetson Orin 裝置上執行 run-pylon-ai-triton-inference-server.sh 指令且裝置處於低功耗模式時,會出現執行階段錯誤。不過,您嘗試載入的模型仍會被載入。為防止此錯誤發生,請在 Jetson Orin 上設定較高的功耗模式。