Instance Segmentation vTool#
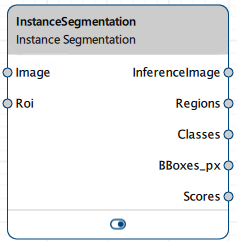
Instance Segmentation vTool 可對透過Image輸入接腳接收的影像中的物件進行分類。其透過InferenceImage、Regions、Classes、BBoxes_px 及Scores等輸出接腳輸出結果。
系統會在每個偵測到的物件周圍繪製一個邊界框。與「Semantic Segmentation 」vTool 不同,實例分割功能可讓您將同一類別中的個別實例進行分割。
若您在分割前使用「ROI Creator vTool 」來指定感興趣區域(ROI),則「Instance Segmentation vTool 」會透過其Roi輸入引腳接收 ROI 資料。在此情況下,分割操作僅針對感興趣區域進行。此舉的附帶效果是能加快處理速度。
如欲購買Instance Segmentation vTool 的授權,請造訪Basler 網站。
運作原理#
假設您想對一張影像進行實體分割,以分別識別並分割每個人的輪廓,不僅要將他們與背景區分開來,還需將他們彼此區分開來。
這是您的輸入圖片,畫面中顯示了六名兒童,背景則是一處山景:
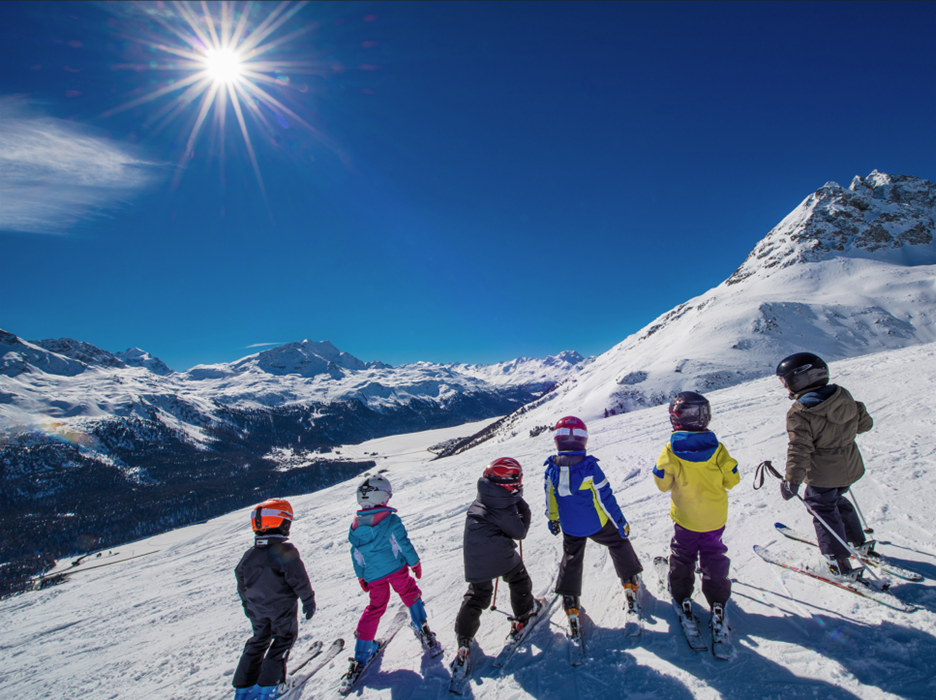
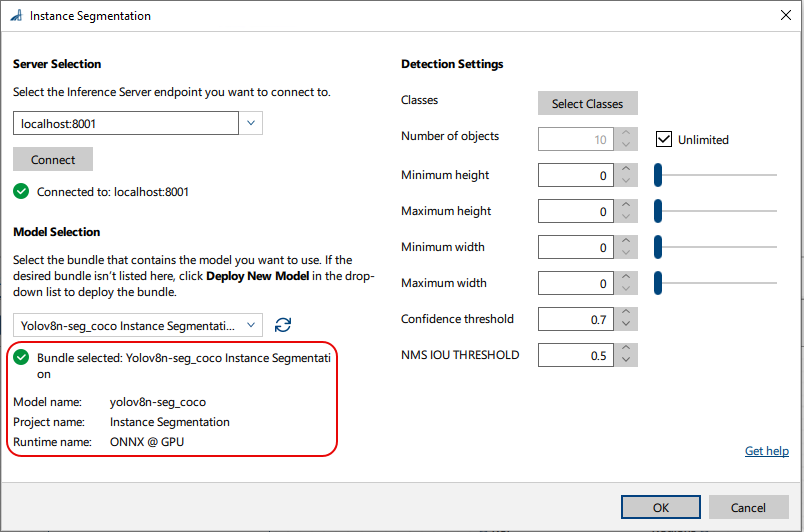
您可透過載入一個已受訓的模型來設定 vTool,該模型能執行實例分割,藉此識別並區分影像中個別物體的實例,本例中即為人物。
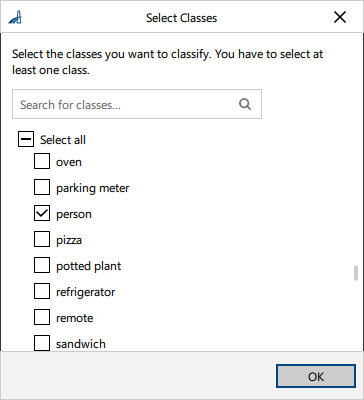
接著,您可以選擇要偵測和分割的類別。某些模型可能正是為您的使用情境量身打造的。在這種情況下,所有所需的類別都已預先選取。
配置完 vTool 後,您需執行該配方以啟動推論流程。vTool 會利用模型來分析影像,並對其中的物件進行分割。分析完成後,系統會回傳分割結果,其中包含分割區域、邊界框,以及影像中偵測到的每個不同實例的標籤。
這是接腳資料檢視中的結果影像:
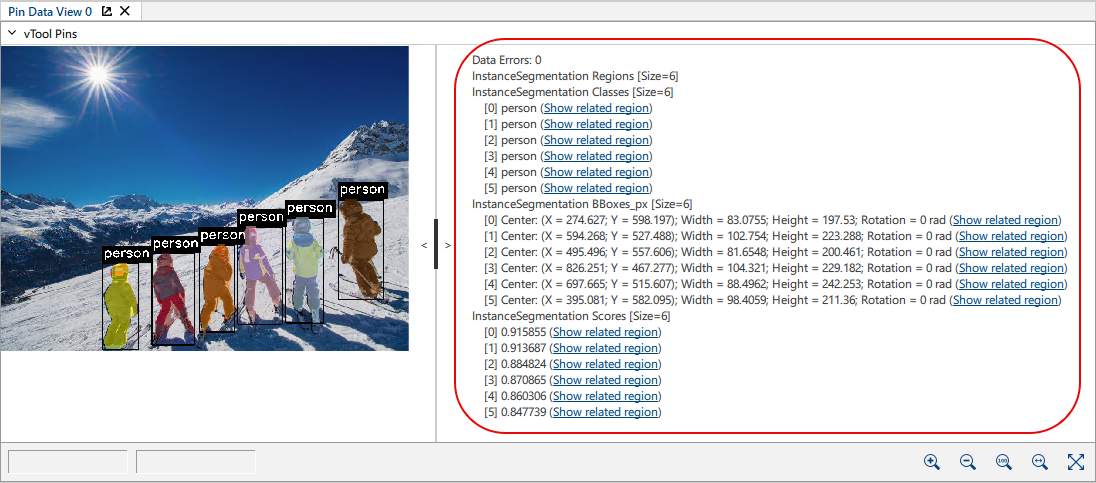
已識別出六人,並將其分割為獨立的人體區域。這些分割區域採用顏色編碼,以區分各個個體。
詳細輸出
- 區域:已偵測到六個區域。影像中的每個物件實例均被標示為一個獨立的區域。這些區域彼此之間以及與背景均有所區隔,使得每個物件都能被清晰辨識。
- 類別:person
類別標籤「person」表示模型將邊界框內的物件識別為「人」。 - 包圍框:包圍框是指圍繞偵測到的物件所繪製的矩形。針對每個包圍框,系統會輸出其中心像素、寬度、高度及旋轉角度。
- 分數:分數值(例如 0.915855)表示模型對其偵測結果的信心程度,例如 91.58%。分數越高、越接近 1.0,表示模型對偵測到的物件確實是人的信心程度越高。
設定 vTool#
要設定「Instance Segmentation vTool 」:
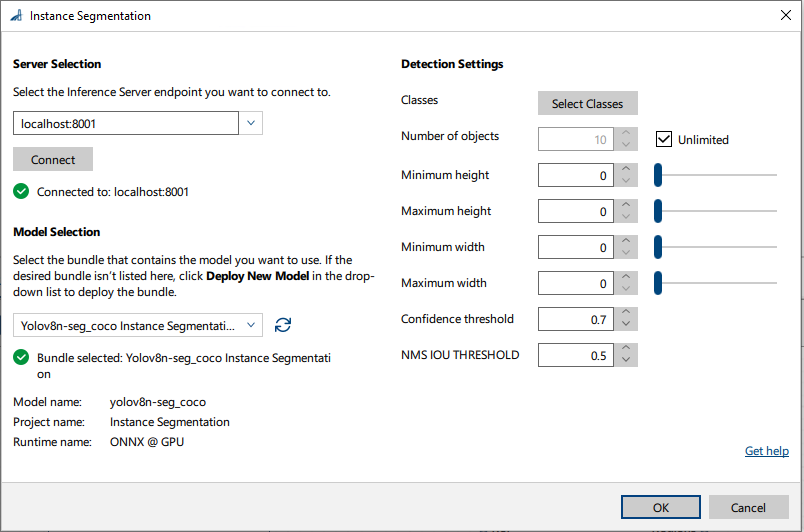
- 在vTool「設定」區域的「配方管理」窗格中,按一下「開啟設定」或雙擊該 vTool。
「執行個體區段」對話方塊隨即開啟。 - 在 伺服器選擇 區域中,請選擇您要連線的伺服器。
伺服器必須處於運行狀態,才能與其建立連線。- 選項 1:手動輸入 Triton Inference Server 的 IP 位址與連接埠。
- 選項 2:在下拉式清單中選取您伺服器的 IP 位址 / 主機名稱與連接埠。
- 按一下 Connect 以建立連線。
接著,vTool 便會載入可用的模型。 - 在 模型選取 區域中,在下拉式清單選取包含所需模型的 bundle。
選取 bundle 後,下拉式清單下方的資訊便會填入該 bundle 的詳細資料,讓您可以確認所選取的 bundle 是否正確。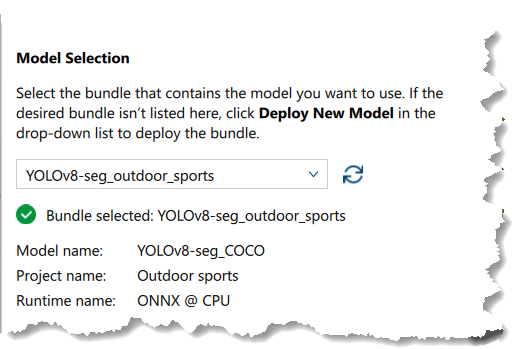
- 如果清單中沒有所需的 bundle,請按一下 部署新模型 下拉式清單中的
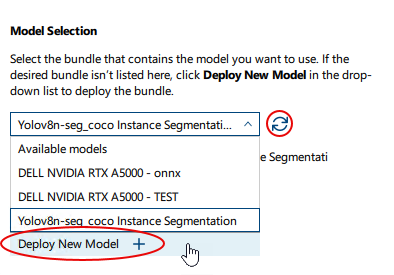
這會開啟 pylon AI Agent ,可讓您部署更多模型。
部署新模型後,您必須按一下 Refresh 按鈕。 -
在「偵測設定」區域中,按一下「選取類別」以選取您要進行分類的類別。
系統將開啟一個顯示可用類別的對話方塊。預設情況下,所有類別均已選取。您可以依需求選取任意數量的類別。資訊
此區域中可用的參數取決於所選的模型。部分參數僅在選取特定模型後才會顯示(例如:NMS IOU 閾值)。預設值由模型提供。
-
請在偵測設定中指定其他選項:
- 物件數量:您可以指定要偵測的物件最大數量,或選擇「無限制」。
此限制適用於每個類別。若影像中的物件數量超過此處指定的數量,系統將偵測分數最高的匹配項目。 - 最大/最小高度:若要根據高度篩選邊界框,請指定適當的數值。由於邊界框的高度對應於物件的高度,因此這可讓您僅偵測到指定大小的物件。
- 最大/最小寬度:若要根據寬度篩選邊界框,請指定適當的數值。由於邊界框的高度等同於物件的寬度,因此這可讓您僅偵測到符合所需尺寸的物件。
- 置信度閾值:置信度是神經網路中的一項係數,用以表示影像中的物件對所選類別的代表性有多高。數值越高,表示置信度越高,且可減少假陽性。
- NMS IOU 閾值:某些邊界框可能會重疊。透過此參數,您可以控制是否要合併這些邊界框。數值越低,容差越小,多數邊界框將會被合併。
- 物件數量:您可以指定要偵測的物件最大數量,或選擇「無限制」。
-
按一下 OK。
您可以在引腳資料檢視中查看分割結果。在此處,您可以選擇要顯示哪些輸出。
Inputs#
Image#
可直接從「相機」vTool 或任何能輸出影像的 vTool(例如「Image Format Converter 」vTool)接收影像。
- 資料類型:圖片
- 影像格式:8 位元至 16 位元彩色影像
Roi#
可接受來自「ROI Creator vTool 」或任何其他會輸出矩形的 vTool 的感興趣區域。若輸入多個矩形,則僅採用第一個作為單一感興趣區域。
- 資料類型:RectangleF、RectangleF Array
Outputs#
若要將 vTool 與 Starter vTools 搭配使用,可將輸出引腳的資料類型從多值資料切換為單值資料。要執行此操作,請在「功能 - 全部」窗格中使用「資料類型選擇器」參數。
推論圖像#
針對每張輸入影像,回傳一張在偵測到的物件周圍繪製了邊界框的影像,以便視覺化顯示結果。
- 資料類型:圖片
Regions#
針對每個類別標籤,回傳一個區域。
- 資料類型:區域陣列
Classes#
回傳所偵測到物件的類別標籤。
- 資料類型:字串陣列
BBoxes_px#
回傳每個偵測到的物件的包圍框。每個包圍框皆由其中心像素的座標、寬度及高度來定義(x_center, y_center, width, height)。此包圍框輸出可作為其他 vTools 的「Roi」輸入接腳的輸入。
- 資料類型:RectangleF 陣列
Scores#
回傳每個預測類別的置信分數。
- 資料類型:Float Array
Payload#
傳回有關 Inference Server 效能的額外資訊以供評估。只有在 Debug Settings パラメーターグループの Features - All ペインで有効にした場合にのみ、この出力ピンを利用できるようになります。
- 資料類型:String